本文へスキップ

BALASAGUN · BRAINSTORM 独自の言語モデル

Balasagun:『クタドグ・ビリグ』の町

Balasagun(バラサグン)はカラハン朝の首都のひとつで、現在のキルギスにあたるチュー川の流域にありました。『クタドグ・ビリグ』(Kutadgu Bilig)の著者ユースフ・ハース・ハージブはこの町で生まれ、ここで作品を書き始めました。完成させたのは1069–70年、カシュガルでのことです。

Kutadgu Bilig は「幸福になるための知識」という意味です。私たちのモデルは、この町の名前をとっています。

自社専用の言語モデルをつくりましょう。

お客様専用の AI 言語モデルが、自社サーバーまたはレンタル GPU 上に常駐して稼働します。モデルはお客様の業務の言葉を話します。お客様が望まない限り、質問も文書も他の AI 企業に送られることはありません。

ステータス

開発中 · ステージ 0 / 3 · 2026年10月

仕組み

モデルはお客様のサーバーに常駐します

お客様のサーバー · またはレンタル GPU011011001001101101外部の AI サービス✕お客様のシステムPMS · ERP · SCADAお客様の文書法規 · ポリシーBALASAGUNお客様のサーバー上BALASAGUNツール計算 · 作業指示ユーザー304号室のエアコンが動きません。304号室 · 保守記録作業指示:エアコン、304号室設備担当に作業指示を出しました。スタッフが部屋に向かっています。住戸の設備容量は 12 kW です。需要電力はどれくらいですか?トルコ電気内線設備規則第57条 · 同時使用率8 kW × 0.6 + 4 kW × 0.4需要電力は 6.4 kW です。出典:内線設備規則 第57条

アニメーション:目指している動作のイメージです。モデルはまだ開発中です。

ホテル

  1. 宿泊客がフロントに連絡:「304号室のエアコンが動きません」
  2. BALASAGUN はホテル自身のサーバーで動きます。質問が他社に送られることはありません。
  3. 客室の保守記録とホテルのシステムを確認します。
  4. 設備担当への作業指示を発行します。
  5. 回答は宿泊客に返り、作業指示は設備担当に届いています。

電気

  1. エンジニアが質問:「住戸の設備容量は 12 kW です。需要電力はどれくらいですか?」
  2. モデルはお客様のサーバー上で考えます。
  3. 同時使用率の規定を、記憶からではなく規則の文書から読み取ります。
  4. ツールで計算します。最初の 8 kW は 0.6、残りは 0.4。
  5. 回答は出典とともに返ります。需要電力は 6.4 kW です。
  1. 1 · 質問が届く宿泊客、スタッフ、エンジニアからの質問
  2. 2 · モデルが考えるお客様のサーバー上で、他社を経由せずに
  3. 3 · 出典を確認する法規、保守記録、ホテルの規程
  4. 4 · 処理を実行する計算し、作業指示を発行
  5. 5 · 回答が返る出典とともに

BALASAGUN とは?

電気工学とホテルのための、私たち独自の言語モデル

BALASAGUN は、私たちがいま電気工学とホテル経営の分野で学習を進めている、独自の AI 言語モデルです。ゼロから学習させるのではありません。オープンソースの言語モデルを、当社のエンジニアリングの知見をもとに必要とされる業界に合わせて学習させ、サービスとして導入し、運用しています。そのため、高価な言語モデルを使う代わりに、自社の言語モデルでソリューションを生み出しています。また、お客様のために開発するお客様専用の LLM を、お客様が選んだ他の LLM とハイブリッドで動作するように構成することもできます。

  • ホテル経営

    宿泊客からの質問、設備対応、エネルギーと保守の管理、スタッフの業務。ホテル独自のルールや料金は、質問のたびに文書から読み取ります。

  • 電気工学

    トルコの電気内線設備、接地、強電設備に関する規則。電圧降下、需要電力、調査と数量拾いの計算。

  • 最初のユーザー:当社の製品

    調査ソフトウェア Elektrik GPT、このサイトのアシスタント Leyla、ARI エネルギー監視が、BALASAGUN を最初に使う製品になります。

    Elektrik GPTエネルギー基盤

私たちの方法

5 つのステップで、お客様のモデルを

どのモデルも同じ 5 つのステップを経ます。BALASAGUN もこの方法で育てており、お客様のモデルも同じ方法で構築します。

育て方

オープンモデルから、お客様のモデルへ

お客様専用の環境✓✓✓当社のテストセットベースモデル調整済みモデル目標:ベース + 10 点以上オープンモデルApache 2.0お客様の知識専門家が承認GPU · 微調整LoRA自社サーバーレンタル GPUお客様専用
  1. 商用利用が可能な(Apache 2.0)ベースモデルを選びます。ゼロからの学習はしません。
  2. 法規、お客様の文書、専門家が承認したルールを加えます。すべての記録の出典を追跡します。
  3. GPU 上で LoRA によるファインチューニング:モデルがお客様の業務の言葉を学びます。
  4. 当社のテストセットで検証します。ベースモデルを上回れなければ、公開しません。
  5. お客様のサーバー、またはお客様専用のレンタル GPU に導入します。
  1. 1 · オープンモデルを選ぶApache 2.0、商用利用可。ライセンスはモデルカードで確認
  2. 2 · 知識を加える法規、お客様の文書、専門家が承認したルール。すべての記録の出典を追跡
  3. 3 · GPU でファインチューニングLoRA。ゼロからの学習はしません
  4. 4 · 試験当社のテストセット。ベースモデルを上回れなければ公開しません
  5. 5 · お客様のもとに導入自社サーバー、またはお客様専用のレンタル GPU。個人データを扱う場合は自社サーバーをおすすめします

私たちの約束

4 つの約束

  • データはお客様の管理下に

    モデルは、お客様のサーバー、またはお客様専用のレンタル GPU で学習し、稼働します。個人データを扱うモデルには、自社サーバーをおすすめします。他の AI 企業のクラウドモデルにリクエストを送るのは、お客様が選んだ業務に限られ、それもお客様が望む場合だけです。

  • ライセンスが明確なモデル、出典をたどれるデータ

    ベースモデルは、必ず商用利用が可能なライセンス(Apache 2.0 / MIT)のものです。すべての学習データには出典とライセンスのメモが残り、必要ならコマンド 1 つで学習から外せます。

  • 丸暗記させない

    価格、条項番号、規程のように変わる情報は、モデルに暗記させません。質問のたびに文書から読み取ります。情報が変わっても、モデルを再学習する必要はありません。

  • 測定せずに公開しない

    すべてのバージョンを当社のテストセットでベースモデルと比較し、上回れないバージョンは使いません。BALASAGUN の最初のバージョンの目標:全体で 10 点以上の向上、どの分野でも 2 点を超える低下なし。

現在の状況

ありのままの状況

最初のバージョンはまだ学習していません。進捗に合わせて、このセクションを更新します。

  1. 0現在

    テストセットとベースモデルの比較選定

  2. 1

    データパイプライン

  3. 2

    最初のバージョンの学習(v0.1)

  4. 3

    提供と連携

  5. v1

    拡張版

学習インフラ

BALASAGUN の学習モデル

これまでに行ったことを、実際の記録とともにご紹介します。ベースモデルの比較選定と、最初の LoRA 試験学習です。本番の学習は次のステップです。ここでは、実際に起きたことをそのままお見せします。

ベースモデルの比較選定

5 つのオープンソースモデルが、当社のテストセットの 50 問(電気 25 問、ホテル 25 問)で競い、オープンウェイトの審査モデルが回答を採点しました。選ばれたベースは Qwen3.6-35B-A3B です。電気分野で 1 位、ライセンスは Apache-2.0 で、2 つの分野別アダプターを 1 台の GPU でまとめて提供するのに適しています。

モデル合計電気ホテル
google/gemma-4-26B-A4B-it87.276.098.4
Qwen/Qwen3.6-35B-A3B採用84.686.482.8
google/gemma-4-12B-it79.664.095.2
Qwen/Qwen3.5-9B73.872.475.2
mistralai/Mistral-Small-3.2-24B-Instruct-250664.655.274.0

100 点満点 · 審査:Qwen3.8-27B · 2026年10月19日
最初の LoRA 試験学習

本番の学習の前に、仕組み全体を端から端まで試しました。同じベースモデルの上で、2 つの LoRA アダプター(電気、ホテル)をそれぞれ 20 ステップ学習させました。学習は正常に動きましたが、続く vLLM による提供のステップは今回の試験でクラッシュしたため、現在修正しています。

GPU
NVIDIA A100 SXM 80 GB(レンタル、RunPod)
VRAM 使用量
69.3 GB(ピーク 69.6 GB)
モデルの読み込み
228 秒
学習
アダプター 2 個 × 20 ステップ、42 秒
学習したパラメーター
アダプターあたり 3,440,640(LoRA r=16)
損失(Loss)
電気 3.89 → 0.88 · ホテル 2.13 → 0.31
Pod の稼働時間
17 分。ジョブ終了後に削除
Pod のログから(そのまま)
15:18:59Z {"olay": "yuklendi", "sn": 228.0, "vram_gb": 69.3, "sinif": "Qwen3_5MoeForCausalLM"}
15:19:00Z {"olay": "adaptor", "adaptor": "elektrik", "egitilebilir": 3440640}
15:19:03Z {"olay": "adim", "adaptor": "elektrik", "adim": 0, "loss": 3.892}
15:19:22Z {"olay": "adim", "adaptor": "elektrik", "adim": 19, "loss": 0.8816}
15:19:22Z {"olay": "adaptor", "adaptor": "otel", "egitilebilir": 3440640}
15:19:23Z {"olay": "adim", "adaptor": "otel", "adim": 0, "loss": 2.1289}
15:19:41Z {"olay": "adim", "adaptor": "otel", "adim": 19, "loss": 0.306}
15:19:42Z {"olay": "egitim_bitti", "sn": 270.4, "vram_gb_max": 69.6}
15:20:00Z vLLM version 0.31.0 · model Qwen/Qwen3.6-35B-A3B · lora_modules: elektrik, otel
Durum: BAŞARISIZ — vLLM kapandı (vllm-exited) · GPU: NVIDIA A100-SXM4-80GB · süre: 17 dk

時刻は UTC です。各行は当社の学習スクリプト自身のログです。

RunPod コンソールから

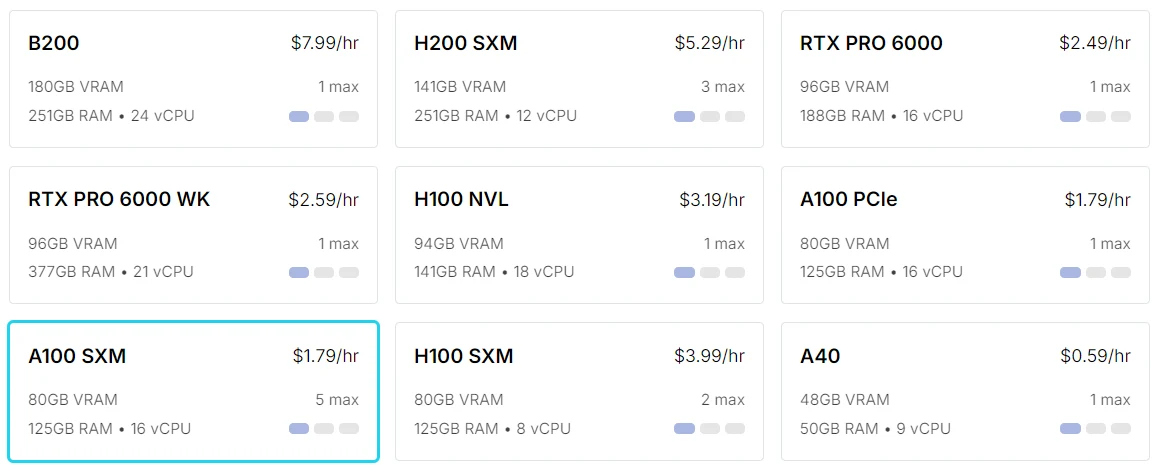
RunPod コンソールの GPU カード。A100 SXM 80 GB VRAM のカードがハイライトされています。
GPU の選択:試験学習は A100 SXM 80 GB で実行しました(ハイライト部分)。価格と在庫はリアルタイムの値です。
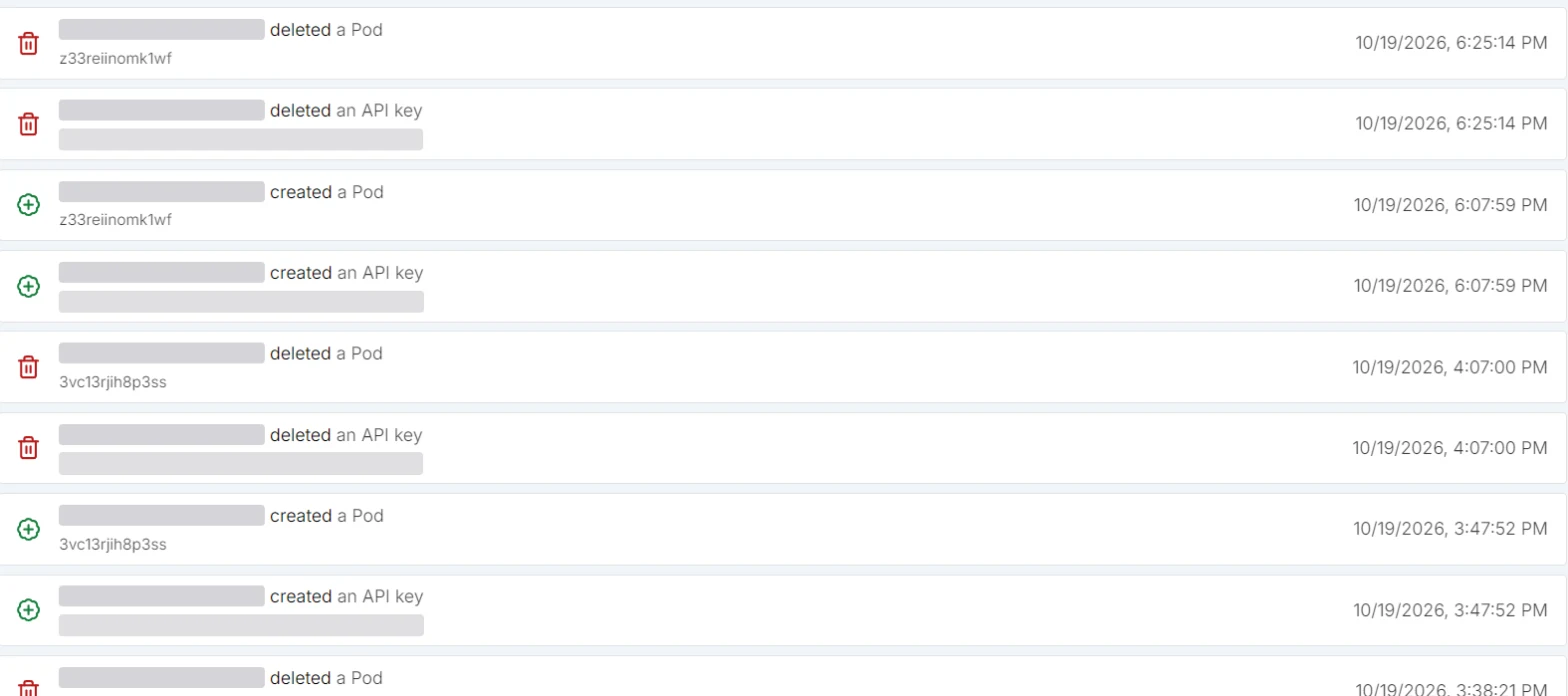
RunPod の監査ログ。pod の作成と削除の行があり、メールアドレスとキー ID は伏せてあります。
監査ログ:試験用の pod は 18:07 に作成され、18:25 に削除されました(トルコ時間)。アカウント情報は伏せてあります。

使用しているソフトウェア

  • Qwen3.6-35B-A3B

    ベースモデル(Apache-2.0)

  • PyTorch + Hugging Face Transformers

    モデルの読み込みと学習

  • PEFT (LoRA)

    分野別アダプター(電気、ホテル)

  • vLLM 0.31.0

    評価と提供(OpenAI 互換エンドポイント)

  • RunPod GPU ポッド

    レンタルの A100 80 GB と RTX A6000 48 GB サーバー

  • Hugging Face Hub

    モデルとアダプター用のプライベートリポジトリ

  • Python 3.12 + uv

    データパイプライン、テストセット、採点器

  • コスト監視 + Oracle クリーナー

    ジョブが終わると pod は停止し、放置された pod は 1.5 時間後に削除されます

次のステップ:本番の学習

専門家が承認したデータによる bf16 LoRA 学習を、80–96 GB の GPU(A100 80 GB または RTX PRO 6000 96 GB)で行います。各アダプターはそれぞれの分野のテストセットで測定し、ベースモデルを上回れないバージョンは公開しません。

お客様の業界に

お客様の業界向けにも構築します。

BALASAGUN を自社のためにつくったのと同じように、お客様の業界向けに独自の言語モデルを構築し、学習させます。自社サーバーでも、レンタル GPU でも構いません。

  • 医療

    患者への情報提供、診療プロトコルや医薬品ガイドの検索。患者データは病院のサーバーに残ります。

  • 法務

    記録のアーカイブと判例の調査、書面の下書き。依頼者の記録は事務所の中に残ります。

  • 財務・会計

    請求書の読み取り、法規に関する質問、取引先別残高の要約。財務記録は会社のサーバーに残ります。

  • 製造・工場

    機械のマニュアル、保守記録、故障診断。生産データは工場の中に残ります。

  • エネルギー・インフラ

    現場報告、故障記録、設備の資料。電力網と設備のデータはお客様の手元に残ります。

  • 行政・自治体

    住民からの申請への回答、法規の検索。個人データは機関のサーバーに残ります。

  • 教育

    授業コンテンツと組織内の知識アシスタント。生徒のデータは学校に残ります。

  • 小売・EC

    商品カタログ、カスタマーサービス、返品ルール。顧客データはお客様の手元に残ります。

業界が一覧にない場合も、ご連絡ください。まずは業務とデータについてお話ししましょう。見積もりを依頼

進め方

最初のご相談から、稼働するモデルまで

期間と価格は、お客様の業務とデータによって変わります。ヒアリングの後、書面でお見積もりをお出しします。

  1. 1. ヒアリング

    業務、データ、機密保持の要件についてお話しします。

  2. 2. データの棚卸しとテストセット

    どの文書や記録を使うかを洗い出し、お客様の実際の質問からテストセットをつくります。

  3. 3. パイロットモデル

    候補のベースモデルを比較し、勝ったモデルをファインチューニングで調整して、測定レポートをお渡しします。

  4. 4. 導入

    モデルをお客様のサーバー、またはお客様専用のレンタル GPU に導入し、お客様のシステムと連携させます。

  5. 5. 保守と新バージョン

    新しい文書や質問でモデルを更新し、バージョンごとに測定し直します。

サーバーとデータセンターの構築(F09)

見積もりを依頼

業界とデータについてお聞かせください。お客様専用モデルのお見積もりをご用意します。

業務の内容とお手元のデータを簡単にお書きください。こちらからご連絡し、ヒアリングの日程を調整します。

ご興味のあるラインを選択してください

現在の状況と、望む結果を書いていただければ十分です。

メッセージは当社チームに直接届きます。適切な担当ラインへ振り分けるため、本文はAIで事前分類されます。お名前と連絡先はこの処理には送信されません。