Saltar al contenido

BALASAGUN · el modelo de lenguaje propio de BRAINSTORM

Balasagun: la ciudad del Kutadgu Bilig

Balasagun fue una de las capitales de los karajánidas, en la cuenca del río Chu, en el actual Kirguistán. Yusuf Has Hacib, autor del Kutadgu Bilig, nació en esta ciudad y comenzó aquí su obra; la terminó en Kasgar en 1069–70.

Kutadgu Bilig significa «el conocimiento de ser feliz». Nuestro modelo toma su nombre de esta ciudad.

Cree su propio modelo de lenguaje.

Un modelo de lenguaje de IA hecho para usted, que vive y trabaja en su propio servidor o en GPU alquiladas. Habla el lenguaje de su negocio; salvo que usted decida lo contrario, sus preguntas y sus documentos nunca van a otra empresa de IA.

Estado

En desarrollo · Fase 0 / 3 · octubre de 2026

Cómo funciona

El modelo vive en su servidor

SU SERVIDOR · o GPU alquilada011011001001101101SERVICIO DE IA EXTERNO✕SUS SISTEMASPMS · ERP · SCADASUS DOCUMENTOSreglamentos · políticasBALASAGUNen su servidorBALASAGUNHERRAMIENTAScálculos · órdenes de trabajoUSUARIOSEn la habitación 304no funciona el aire acondicionado.hab. 304 · registro de mantenimientoabrir orden de trabajo: A/A, hab. 304Orden de trabajo abierta;el equipo va hacia la habitación.Potencia instalada del piso: 12 kW.¿Cuál es la potencia demandada?Reglamento de Inst. Eléctricasart. 57 · coef. de simultaneidad8 kW × 0,6 + 4 kW × 0,4Potencia demandada: 6,4 kW.Fuente: Regl. Instalaciones, art. 57

Animación: el funcionamiento previsto. El modelo todavía está en desarrollo.

HOTEL

  1. Un huésped escribe a recepción: «En la habitación 304 no funciona el aire acondicionado».
  2. BALASAGUN funciona en el servidor del propio hotel; la pregunta no va a ninguna otra empresa.
  3. Consulta el registro de mantenimiento de la habitación y el sistema del hotel.
  4. Abre una orden de trabajo para el servicio técnico.
  5. La respuesta vuelve al huésped; la orden de trabajo queda en el servicio técnico.

ELECTRICIDAD

  1. Un ingeniero pregunta: «El piso tiene 12 kW de potencia instalada. ¿Cuál es la potencia demandada?».
  2. El modelo piensa en su servidor.
  3. Lee la regla de simultaneidad en el propio reglamento, no de memoria.
  4. Calcula con una herramienta: 0,6 para los primeros 8 kW y 0,4 para el resto.
  5. La respuesta vuelve con su fuente: una potencia demandada de 6,4 kW.
  1. 1 · Llega una preguntapregunta un huésped, un empleado o un ingeniero
  2. 2 · El modelo piensaen su servidor, sin pasar por otra empresa
  3. 3 · Consulta la fuentereglamento, registro de mantenimiento, política del hotel
  4. 4 · Actúacalcula, abre una orden de trabajo
  5. 5 · Vuelve la respuestajunto con su fuente

¿Qué es BALASAGUN?

Nuestro propio modelo de lenguaje para la ingeniería eléctrica y los hoteles

BALASAGUN es el modelo de lenguaje de IA que estamos entrenando ahora mismo para la ingeniería eléctrica y la gestión hotelera. No entrenamos desde cero: tomamos modelos de lenguaje de código abierto, los entrenamos con nuestra propia experiencia en ingeniería para el sector que se necesite, y los ponemos en servicio y en funcionamiento. Así, en lugar de usar modelos de lenguaje caros, creamos soluciones con nuestro propio modelo de lenguaje. Además, podemos configurar su propio LLM, que desarrollaremos para usted, para que funcione de forma híbrida con los demás LLM que usted elija.

  • Gestión hotelera

    Preguntas de los huéspedes, servicio técnico, seguimiento de la energía y del mantenimiento, tareas del personal. Las reglas y los precios propios del hotel se leen de sus documentos en cada pregunta.

  • Ingeniería eléctrica

    Reglamentos turcos de instalaciones eléctricas interiores, puesta a tierra e instalaciones de potencia (corrientes fuertes); cálculos de caída de tensión, potencia demandada, levantamiento y mediciones.

  • Primeros usuarios: nuestros propios productos

    El software de levantamiento Elektrik GPT, Leyla, la asistente de este sitio, y la plataforma de monitorización energética ARI serán los primeros productos en usar BALASAGUN.

    Elektrik GPTPlataforma Energética

Cómo lo hacemos

Su modelo en cinco pasos

Todos los modelos pasan por los mismos cinco pasos. Así estamos entrenando BALASAGUN, y así construimos el suyo.

Cómo crece

De un modelo abierto a su modelo

SU ENTORNO DEDICADO✓✓✓NUESTRO CONJUNTO DE PRUEBASmodelo basemodelo adaptadoobjetivo: base + 10 pts o másMODELO ABIERTOApache 2.0SU CONOCIMIENTOaprobado por expertosGPU · AJUSTE FINOLoRASU PROPIO SERVIDORGPU ALQUILADAdedicada a usted
  1. Se elige un modelo base con licencia para uso comercial (Apache 2.0). Sin entrenamiento desde cero.
  2. Se añaden reglamentos, sus propios documentos y reglas aprobadas por expertos; se traza la fuente de cada registro.
  3. Ajuste fino con LoRA en una GPU: el modelo aprende el lenguaje de su negocio.
  4. Se prueba con nuestro propio conjunto de pruebas. Si no supera al modelo base, no entra en producción.
  5. Se instala en su propio servidor o en una GPU alquilada dedicada a usted.
  1. 1 · Se elige un modelo abiertoApache 2.0, con licencia para uso comercial; la licencia se lee en la ficha del modelo
  2. 2 · Se añade su conocimientoreglamentos, sus documentos, reglas aprobadas por expertos; se traza la fuente de cada registro
  3. 3 · Ajuste fino en una GPULoRA; sin entrenamiento desde cero
  4. 4 · El examennuestro propio conjunto de pruebas; si no supera al modelo base, no entra en producción
  5. 5 · Se instala para ustedsu propio servidor o una GPU alquilada dedicada a usted; para datos personales recomendamos su propio servidor

Nuestros compromisos

Cuatro compromisos

  • Sus datos, bajo su control

    El modelo se entrena y funciona en su propio servidor o en una GPU alquilada dedicada a usted. Para los modelos que vayan a tratar datos personales, recomendamos su propio servidor. Las peticiones al modelo en la nube de otra empresa de IA solo se envían en las tareas que usted elija, y solo si usted lo desea.

  • Un modelo con licencia clara, datos trazables

    El modelo base siempre tiene licencia para uso comercial (Apache 2.0 / MIT). Cada registro de entrenamiento conserva su fuente y su nota de licencia, y puede retirarse del entrenamiento con un solo comando.

  • Nada de memorizar

    La información que cambia, como precios, números de artículo y políticas, nunca la memoriza el modelo; se lee del documento en cada pregunta. Cuando la información cambia, no hace falta volver a entrenar el modelo.

  • Nada entra en producción sin medirse

    Cada versión se compara con el modelo base en nuestro propio conjunto de pruebas; una versión que no lo supera no se utiliza. Nuestro objetivo para la primera versión de BALASAGUN: al menos 10 puntos más en total y ningún área con un retroceso de más de 2 puntos.

Dónde estamos ahora

Estado real

La primera versión aún no se ha entrenado; actualizamos esta sección a medida que avanzamos.

  1. 0ahora

    Conjunto de pruebas y competición de modelos base

  2. 1

    Canalización de datos

  3. 2

    Entrenamiento de la primera versión (v0.1)

  4. 3

    Puesta en servicio e integración

  5. v1

    Versión ampliada

Infraestructura de entrenamiento

El modelo de entrenamiento de BALASAGUN

Lo que hemos hecho hasta ahora, con los registros reales: la competición de modelos base y el primer entrenamiento de prueba con LoRA. El entrenamiento completo es el siguiente paso; aquí mostramos exactamente lo que ocurrió.

Competición de modelos base

Cinco modelos de código abierto compitieron en 50 preguntas de nuestro propio conjunto de pruebas (25 de electricidad, 25 de hotel); un modelo juez de pesos abiertos puntuó las respuestas. Elegimos como base Qwen3.6-35B-A3B: el primero en ingeniería eléctrica, con licencia Apache-2.0 y adecuado para servir juntos los dos adaptadores de dominio en una sola GPU.

ModeloTotalElectricidadHotel
google/gemma-4-26B-A4B-it87,276,098,4
Qwen/Qwen3.6-35B-A3Belegido84,686,482,8
google/gemma-4-12B-it79,664,095,2
Qwen/Qwen3.5-9B73,872,475,2
mistralai/Mistral-Small-3.2-24B-Instruct-250664,655,274,0

Puntuación sobre 100 · juez: Qwen3.8-27B · 19 de octubre de 2026
Primer entrenamiento de prueba con LoRA

Antes del entrenamiento completo probamos el montaje de principio a fin: se entrenaron dos adaptadores LoRA (electricidad, hotel) durante 20 pasos cada uno sobre la misma base. El entrenamiento funcionó; el paso siguiente, la puesta en servicio con vLLM, falló en esta prueba y se está corrigiendo.

GPU
NVIDIA A100 SXM 80 GB (alquilada, RunPod)
VRAM utilizada
69,3 GB (máximo 69,6 GB)
Carga del modelo
228 s
Entrenamiento
2 adaptadores × 20 pasos, 42 s
Parámetros entrenados
3.440.640 por adaptador (LoRA r=16)
Loss
electricidad 3,89 → 0,88 · hotel 2,13 → 0,31
Tiempo del pod
17 min; eliminado al terminar el trabajo
Del registro del pod (tal cual)
15:18:59Z {"olay": "yuklendi", "sn": 228.0, "vram_gb": 69.3, "sinif": "Qwen3_5MoeForCausalLM"}
15:19:00Z {"olay": "adaptor", "adaptor": "elektrik", "egitilebilir": 3440640}
15:19:03Z {"olay": "adim", "adaptor": "elektrik", "adim": 0, "loss": 3.892}
15:19:22Z {"olay": "adim", "adaptor": "elektrik", "adim": 19, "loss": 0.8816}
15:19:22Z {"olay": "adaptor", "adaptor": "otel", "egitilebilir": 3440640}
15:19:23Z {"olay": "adim", "adaptor": "otel", "adim": 0, "loss": 2.1289}
15:19:41Z {"olay": "adim", "adaptor": "otel", "adim": 19, "loss": 0.306}
15:19:42Z {"olay": "egitim_bitti", "sn": 270.4, "vram_gb_max": 69.6}
15:20:00Z vLLM version 0.31.0 · model Qwen/Qwen3.6-35B-A3B · lora_modules: elektrik, otel
Durum: BAŞARISIZ — vLLM kapandı (vllm-exited) · GPU: NVIDIA A100-SXM4-80GB · süre: 17 dk

Horas en UTC. Las líneas son el registro de nuestro propio script de entrenamiento.

Desde la consola de RunPod

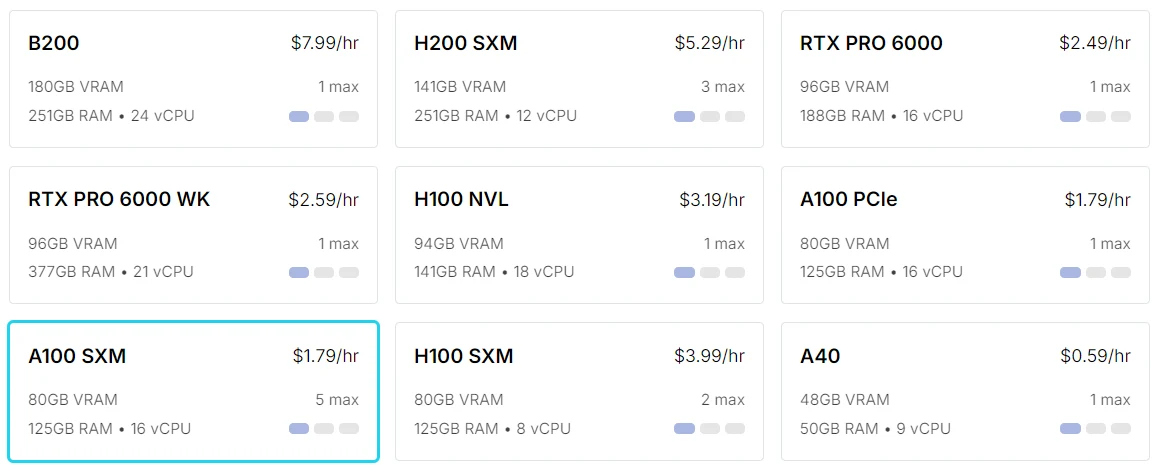
Tarjetas de GPU en la consola de RunPod; la tarjeta A100 SXM con 80 GB de VRAM aparece resaltada.
Selección de GPU: el entrenamiento de prueba se hizo en una A100 SXM 80 GB (resaltada). Los precios y la disponibilidad son valores en tiempo real.
Registro de auditoría de RunPod con las filas de creación y eliminación del pod; el correo electrónico y los ID de clave están ocultos.
Registro de auditoría: el pod de prueba se creó a las 18:07 y se eliminó a las 18:25 (hora de Turquía). Los datos de la cuenta están ocultos.

Software que utilizamos

  • Qwen3.6-35B-A3B

    modelo base (Apache-2.0)

  • PyTorch + Hugging Face Transformers

    carga y entrenamiento del modelo

  • PEFT (LoRA)

    adaptadores de dominio (electricidad, hotel)

  • vLLM 0.31.0

    evaluación y puesta en servicio (endpoint compatible con OpenAI)

  • Pods de GPU de RunPod

    servidores alquilados con A100 80 GB y RTX A6000 48 GB

  • Hugging Face Hub

    repositorios privados para modelos y adaptadores

  • Python 3.12 + uv

    canalización de datos, conjunto de pruebas y evaluadores

  • Vigilante de costes + limpiador de Oracle

    el pod se apaga al terminar su trabajo; un pod olvidado se elimina tras 1,5 horas

Siguiente paso: el entrenamiento completo

Entrenamiento LoRA en bf16 con datos aprobados por expertos, en una GPU de 80–96 GB (A100 80 GB o RTX PRO 6000 96 GB). Cada adaptador se mide con el conjunto de pruebas de su propio dominio; una versión que no supera al modelo base no entra en producción.

Para su sector

También podemos crear uno para su sector.

Igual que creamos BALASAGUN para nosotros, configuramos y entrenamos su propio modelo de lenguaje para su sector: en su propio servidor o en GPU alquiladas.

  • Sanidad

    Información al paciente, búsqueda en protocolos y guías de medicamentos. Los datos de los pacientes se quedan en el servidor del hospital.

  • Derecho

    Archivo de expedientes y búsqueda de jurisprudencia, borradores de escritos. Los expedientes de los clientes se quedan en el despacho.

  • Finanzas y contabilidad

    Lectura de facturas, consultas sobre normativa, resúmenes de cuentas. Los registros financieros se quedan en el servidor de la empresa.

  • Fabricación

    Manuales de máquinas, registros de mantenimiento, diagnóstico de averías. Los datos de producción se quedan en la fábrica.

  • Energía e infraestructuras

    Informes de campo, registros de averías, documentación de las plantas. Los datos de la red y de las plantas se quedan con usted.

  • Sector público y ayuntamientos

    Respuestas a las solicitudes de los ciudadanos, búsqueda de normativa. Los datos personales se quedan en el servidor de la institución.

  • Educación

    Contenidos de los cursos y un asistente de conocimiento interno. Los datos de los alumnos se quedan en el centro educativo.

  • Comercio minorista y electrónico

    Catálogo de productos, atención al cliente, reglas de devolución. Los datos de los clientes se quedan con usted.

¿Su sector no aparece? Escríbanos; hablemos primero de su negocio y de sus datos.Pedir presupuesto

Cómo trabajamos juntos

De la primera conversación a un modelo en funcionamiento

El plazo y el precio dependen de su negocio y de sus datos; tras la reunión inicial le enviamos un presupuesto por escrito.

  1. 1. Reunión inicial

    Hablamos de su negocio, de sus datos y de sus requisitos de privacidad.

  2. 2. Inventario de datos y conjunto de pruebas

    Determinamos qué documentos y registros se van a usar y creamos un conjunto de pruebas con sus preguntas reales.

  3. 3. Modelo piloto

    Ponemos a competir modelos base candidatos, adaptamos el ganador mediante ajuste fino y le entregamos el informe de medición.

  4. 4. Instalación

    Instalamos el modelo en su propio servidor o en una GPU alquilada dedicada a usted y lo conectamos a sus sistemas.

  5. 5. Mantenimiento y nuevas versiones

    Actualizamos el modelo con nuevos documentos y preguntas, y volvemos a medir cada versión.

Instalación de servidores y centro de datos (F09)

Pedir presupuesto

Cuéntenos su sector y sus datos; le prepararemos un presupuesto para su propio modelo.

Escríbanos brevemente sobre su negocio y los datos de que dispone; le responderemos para concertar una reunión inicial.

Elija la línea que le interesa

Basta con la situación actual y el resultado que busca.

Su mensaje llega directamente a nuestro equipo. Para dirigirlo a la línea adecuada, el texto del mensaje se preclasifica con IA; su nombre y sus datos de contacto no se envían a ese paso.