Zum Inhalt springen

BALASAGUN · das eigene Sprachmodell von BRAINSTORM

Balasagun: die Stadt des Kutadgu Bilig

Balasagun war eine der Hauptstädte der Karachaniden und lag im Becken des Flusses Tschu, im heutigen Kirgisistan. Yusuf Has Hacib, der Verfasser des Kutadgu Bilig, wurde hier geboren und begann sein Werk in dieser Stadt; vollendet hat er es 1069–70 in Kaschgar.

Kutadgu Bilig bedeutet „das Wissen vom Glücklichsein“. Unser Modell trägt den Namen dieser Stadt.

Erschaffen Sie Ihr eigenes Sprachmodell.

Ein KI-Sprachmodell nur für Sie, das auf Ihrem eigenen Server oder auf gemieteten GPUs lebt und arbeitet. Es spricht die Sprache Ihres Geschäfts; solange Sie es nicht anders wollen, gehen Ihre Fragen und Dokumente an kein anderes KI-Unternehmen.

Status

In Entwicklung · Phase 0 / 3 · Oktober 2026

So funktioniert es

Das Modell lebt auf Ihrem Server

IHR SERVER · oder gemietete GPU011011001001101101EXTERNER KI-DIENST✕IHRE SYSTEMEPMS · ERP · SCADAIHRE DOKUMENTEVorschriften · RichtlinienBALASAGUNauf Ihrem ServerBALASAGUNWERKZEUGERechnen · ArbeitsauftragNUTZERZimmer 304: Die Klimaanlagefunktioniert nicht.Zimmer 304 · WartungsprotokollAuftrag: Klima, Zimmer 304Arbeitsauftrag angelegt,das Team ist unterwegs.Wohnung: 12 kW installierte Leistung.Wie hoch ist die Bedarfsleistung?Türk. InstallationsverordnungArt. 57 · Gleichzeitigkeit8 kW × 0,6 + 4 kW × 0,4Bedarfsleistung: 6,4 kW.Quelle: Installationsvo. Art. 57

Animation: So soll es arbeiten. Das Modell ist noch in Entwicklung.

HOTEL

  1. Ein Gast schreibt an die Rezeption: „In Zimmer 304 funktioniert die Klimaanlage nicht.“
  2. BALASAGUN läuft auf dem hoteleigenen Server; die Frage geht an keine andere Firma.
  3. Es prüft das Wartungsprotokoll des Zimmers und das Hotelsystem.
  4. Es legt einen Arbeitsauftrag für den technischen Dienst an.
  5. Die Antwort geht an den Gast; der Auftrag liegt beim technischen Dienst.

ELEKTRO

  1. Ein Ingenieur fragt: „Die Wohnung hat 12 kW installierte Leistung. Wie hoch ist die Bedarfsleistung?“
  2. Das Modell denkt auf Ihrem Server.
  3. Es liest die Gleichzeitigkeitsregel aus der Vorschrift selbst, nicht aus dem Gedächtnis.
  4. Es rechnet mit einem Werkzeug: 0,6 für die ersten 8 kW, 0,4 für den Rest.
  5. Die Antwort kommt mit Quelle zurück: 6,4 kW Bedarfsleistung.
  1. 1 · Eine Frage kommtGast, Mitarbeiter oder Ingenieur fragt
  2. 2 · Das Modell denktauf Ihrem Server, ohne Umweg über eine andere Firma
  3. 3 · Es prüft die QuelleVorschrift, Wartungsprotokoll, Hotelrichtlinie
  4. 4 · Es handeltrechnet, legt einen Arbeitsauftrag an
  5. 5 · Die Antwort kommt zurückmit ihrer Quelle

Was ist BALASAGUN?

Unser eigenes Sprachmodell für Elektrotechnik und Hotels

BALASAGUN ist das KI-Sprachmodell, das wir gerade für Elektrotechnik und Hotelmanagement trainieren. Wir trainieren nicht von Grund auf: Wir nehmen quelloffene Sprachmodelle, trainieren sie mit unserem eigenen Ingenieurwissen passend für die jeweilige Branche, nehmen sie in Betrieb und betreiben sie. So bauen wir Lösungen mit unserem eigenen Sprachmodell, statt teure Sprachmodelle zu nutzen. Das LLM, das wir für Sie entwickeln, können wir zudem so einrichten, dass es hybrid mit anderen LLMs Ihrer Wahl zusammenarbeitet.

  • Hotelmanagement

    Gästefragen, technischer Dienst, Energie- und Wartungsverfolgung, Personalaufgaben. Regeln und Preise des Hotels werden bei jeder Frage aus dessen Dokumenten gelesen.

  • Elektrotechnik

    Türkische Vorschriften zu Elektroinstallationen, Erdung und Starkstromanlagen; Spannungsfall, Bedarfsleistung, Aufmaß und Mengenermittlung.

  • Erste Nutzer: unsere eigenen Produkte

    Die Aufmaß-Software Elektrik GPT, Leyla, die Assistentin dieser Website, und ARI Energiemonitoring werden BALASAGUN als Erste nutzen.

    Elektrik GPTEnergie-Plattform

So gehen wir vor

Ihr Modell in fünf Schritten

Jedes Modell durchläuft dieselben fünf Schritte. So trainieren wir BALASAGUN, und so bauen wir auch Ihr Modell.

So wächst es

Vom offenen Modell zu Ihrem Modell

IHRE EIGENE UMGEBUNG✓✓✓UNSER TESTSETBasismodellangepasstes ModellZiel: Basis + mind. 10 PunkteOFFENES MODELLApache 2.0IHR WISSENfachlich geprüftGPU · FEINABSTIMMUNGLoRAEIGENER SERVERGEMIETETE GPUnur für Sie
  1. Ein kommerziell nutzbares Basismodell (Apache 2.0) wird gewählt. Kein Training von Grund auf.
  2. Vorschriften, Ihre eigenen Dokumente und geprüfte Regeln kommen dazu; jede Quelle bleibt nachvollziehbar.
  3. Feinabstimmung mit LoRA auf der GPU: Das Modell lernt die Sprache Ihres Geschäfts.
  4. Es wird an unserem eigenen Testset geprüft. Schlägt es das Basismodell nicht, geht es nicht live.
  5. Es wird auf Ihrem eigenen Server oder einer nur für Sie gemieteten GPU installiert.
  1. 1 · Offenes Modell wählenApache 2.0, kommerziell nutzbar; die Lizenz steht in der Modellkarte
  2. 2 · Ihr Wissen kommt dazuVorschriften, Ihre Dokumente, geprüfte Regeln; jede Quelle bleibt nachvollziehbar
  3. 3 · Feinabstimmung auf der GPULoRA; kein Training von Grund auf
  4. 4 · Die Prüfungunser eigenes Testset; wer das Basismodell nicht schlägt, geht nicht live
  5. 5 · Installation bei Ihneneigener Server oder eine nur für Sie gemietete GPU; für personenbezogene Daten empfehlen wir den eigenen Server

Unsere Zusagen

Vier Zusagen

  • Ihre Daten unter Ihrer Kontrolle

    Das Modell wird auf Ihrem eigenen Server oder einer nur für Sie gemieteten GPU trainiert und betrieben. Für Modelle, die personenbezogene Daten verarbeiten, empfehlen wir den eigenen Server. Anfragen an das Cloud-Modell eines anderen KI-Unternehmens gibt es nur für Aufgaben, die Sie auswählen, und nur, wenn Sie es wollen.

  • Klare Modelllizenz, nachvollziehbare Daten

    Das Basismodell ist immer kommerziell nutzbar lizenziert (Apache 2.0 / MIT). Jeder Trainingsdatensatz behält Quelle und Lizenzhinweis und lässt sich mit einem Befehl aus dem Training entfernen.

  • Kein Auswendiglernen

    Was sich ändert, etwa Preise, Paragrafennummern oder Richtlinien, lernt das Modell nicht auswendig; es liest es bei jeder Frage aus dem Dokument. Ändert sich die Information, muss das Modell nicht neu trainiert werden.

  • Nichts geht ungemessen live

    Jede Version wird an unserem eigenen Testset mit dem Basismodell verglichen; wer es nicht schlägt, wird nicht eingesetzt. Unser Ziel für die erste BALASAGUN-Version: insgesamt mindestens 10 Punkte besser, in keinem Bereich mehr als 2 Punkte schlechter.

Wo wir stehen

Ehrlicher Stand

Die erste Version ist noch nicht trainiert; wir aktualisieren diesen Abschnitt mit jedem Schritt.

  1. 0jetzt

    Testset und Vergleich der Basismodelle

  2. 1

    Datenpipeline

  3. 2

    Training der ersten Version (v0.1)

  4. 3

    Bereitstellung und Anbindung

  5. v1

    Breitere Version

Trainingsinfrastruktur

Das BALASAGUN-Trainingsmodell

Was wir bisher getan haben, mit den echten Protokollen: der Vergleich der Basismodelle und das erste LoRA-Probetraining. Das eigentliche Training ist der nächste Schritt; hier zeigen wir genau, was passiert ist.

Vergleich der Basismodelle

Fünf Open-Source-Modelle traten bei 50 Fragen aus unserem eigenen Testset an (25 Elektro, 25 Hotel); ein Richtermodell mit offenen Gewichten bewertete die Antworten. Gewählte Basis ist Qwen3.6-35B-A3B: Platz eins in der Elektrotechnik, Apache-2.0-Lizenz und geeignet, beide Fachadapter zusammen auf einer GPU bereitzustellen.

ModellGesamtElektroHotel
google/gemma-4-26B-A4B-it87,276,098,4
Qwen/Qwen3.6-35B-A3Bgewählt84,686,482,8
google/gemma-4-12B-it79,664,095,2
Qwen/Qwen3.5-9B73,872,475,2
mistralai/Mistral-Small-3.2-24B-Instruct-250664,655,274,0

Punkte von 100 · Richter: Qwen3.8-27B · 19. Oktober 2026
Erstes LoRA-Probetraining

Vor dem eigentlichen Training haben wir den Aufbau von Anfang bis Ende getestet: Zwei LoRA-Adapter (Elektro, Hotel) wurden auf derselben Basis je 20 Schritte trainiert. Das Training lief; der folgende Schritt, die Bereitstellung mit vLLM, ist in diesem Versuch abgestürzt und wird behoben.

GPU
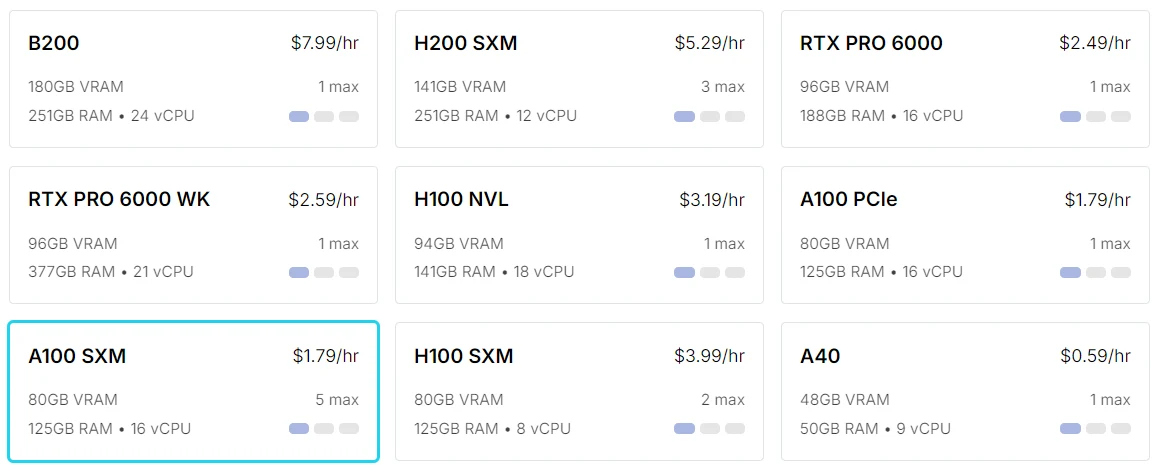
NVIDIA A100 SXM 80 GB (gemietet, RunPod)
VRAM-Nutzung
69,3 GB (Spitze 69,6 GB)
Laden des Modells
228 s
Training
2 Adapter × 20 Schritte, 42 s
Trainierte Parameter
3.440.640 je Adapter (LoRA r=16)
Loss
Elektro 3,89 → 0,88 · Hotel 2,13 → 0,31
Pod-Laufzeit
17 Min.; nach dem Job gelöscht
Aus dem Pod-Protokoll (unverändert)
15:18:59Z {"olay": "yuklendi", "sn": 228.0, "vram_gb": 69.3, "sinif": "Qwen3_5MoeForCausalLM"}
15:19:00Z {"olay": "adaptor", "adaptor": "elektrik", "egitilebilir": 3440640}
15:19:03Z {"olay": "adim", "adaptor": "elektrik", "adim": 0, "loss": 3.892}
15:19:22Z {"olay": "adim", "adaptor": "elektrik", "adim": 19, "loss": 0.8816}
15:19:22Z {"olay": "adaptor", "adaptor": "otel", "egitilebilir": 3440640}
15:19:23Z {"olay": "adim", "adaptor": "otel", "adim": 0, "loss": 2.1289}
15:19:41Z {"olay": "adim", "adaptor": "otel", "adim": 19, "loss": 0.306}
15:19:42Z {"olay": "egitim_bitti", "sn": 270.4, "vram_gb_max": 69.6}
15:20:00Z vLLM version 0.31.0 · model Qwen/Qwen3.6-35B-A3B · lora_modules: elektrik, otel
Durum: BAŞARISIZ — vLLM kapandı (vllm-exited) · GPU: NVIDIA A100-SXM4-80GB · süre: 17 dk

Zeiten in UTC. Die Zeilen sind das Protokoll unseres eigenen Trainingsskripts.

Aus der RunPod-Konsole

GPU-Karten in der RunPod-Konsole; die Karte A100 SXM mit 80 GB VRAM ist hervorgehoben.
GPU-Auswahl: Das Probetraining lief auf einer A100 SXM 80 GB (hervorgehoben). Preise und Verfügbarkeit sind Live-Werte.
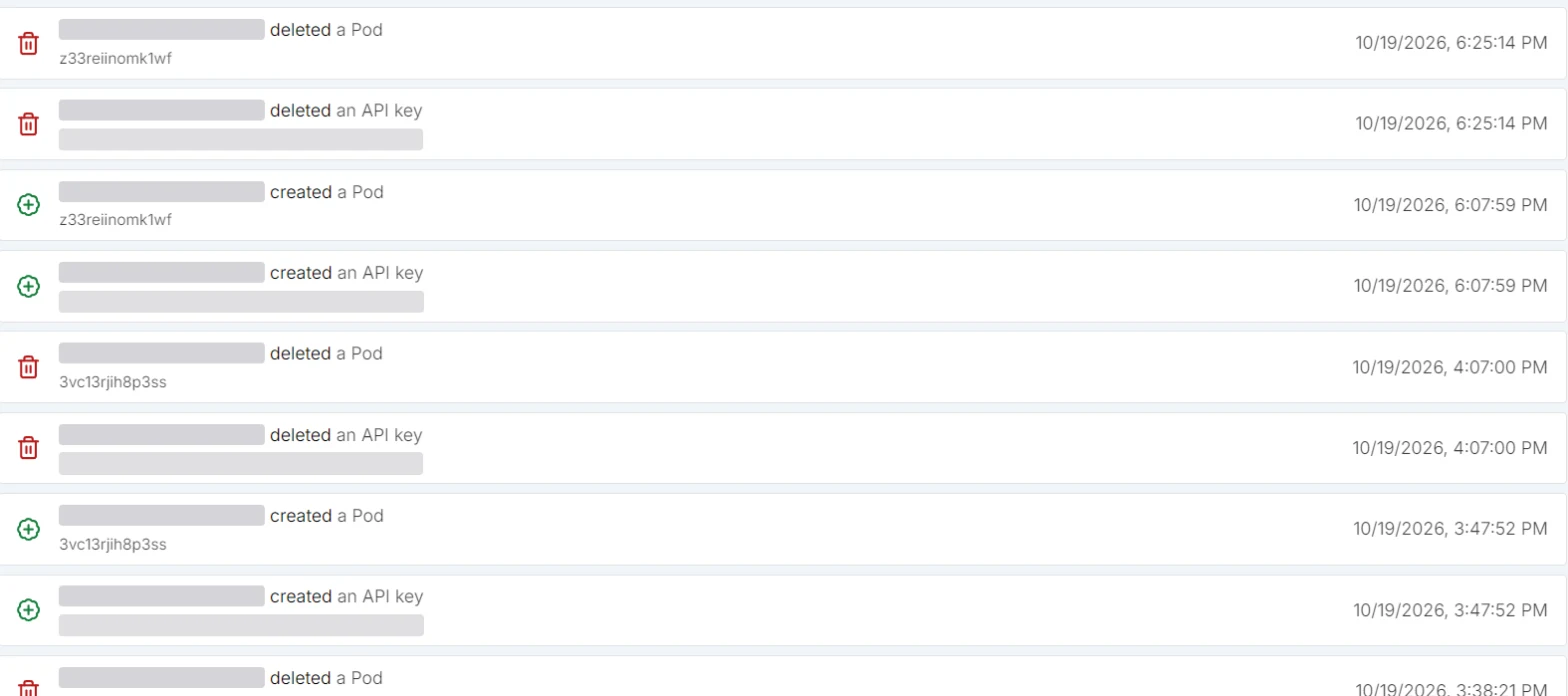
RunPod-Audit-Protokoll mit Zeilen zum Erstellen und Löschen von Pods; E-Mail und Schlüssel-IDs sind abgedeckt.
Audit-Protokoll: Der Probe-Pod wurde um 18:07 erstellt und um 18:25 gelöscht (türkische Zeit). Kontodaten sind abgedeckt.

Software, die wir einsetzen

  • Qwen3.6-35B-A3B

    Basismodell (Apache-2.0)

  • PyTorch + Hugging Face Transformers

    Laden und Trainieren des Modells

  • PEFT (LoRA)

    Fachadapter (Elektro, Hotel)

  • vLLM 0.31.0

    Bewertung und Bereitstellung (OpenAI-kompatibler Endpunkt)

  • RunPod-GPU-Pods

    gemietete Server mit A100 80 GB und RTX A6000 48 GB

  • Hugging Face Hub

    private Repositorys für Modelle und Adapter

  • Python 3.12 + uv

    Datenpipeline, Testset und Bewerter

  • Kostenwächter + Oracle-Bereiniger

    ein Pod schaltet sich nach dem Job ab; ein vergessener Pod wird nach 1,5 Stunden gelöscht

Als Nächstes: das eigentliche Training

bf16-LoRA-Training mit fachlich geprüften Daten auf einer GPU mit 80–96 GB (A100 80 GB oder RTX PRO 6000 96 GB). Jeder Adapter wird am Testset seines Fachgebiets gemessen; eine Version, die das Basismodell nicht schlägt, geht nicht live.

Für Ihre Branche

Wir bauen es auch für Ihre Branche.

So wie wir BALASAGUN für uns gebaut haben, richten wir Ihr eigenes Sprachmodell für Ihre Branche ein und trainieren es: auf Ihrem eigenen Server oder auf gemieteten GPUs.

  • Gesundheit

    Patienteninformation, Suche in Protokollen und Arzneimittelleitfäden. Patientendaten bleiben auf dem Server des Krankenhauses.

  • Recht

    Aktenarchiv und Rechtsprechungsrecherche, Schriftsatzentwürfe. Mandantenakten bleiben in der Kanzlei.

  • Finanzen und Buchhaltung

    Rechnungen lesen, Fragen zu Vorschriften, Kontoübersichten. Finanzdaten bleiben auf dem Server des Unternehmens.

  • Produktion und Fabrik

    Maschinenhandbücher, Wartungsprotokolle, Fehlerdiagnose. Produktionsdaten bleiben in der Fabrik.

  • Energie und Infrastruktur

    Feldberichte, Störungsprotokolle, Anlagendokumente. Netz- und Anlagendaten bleiben bei Ihnen.

  • Verwaltung und Kommunen

    Antworten auf Bürgeranfragen, Vorschriftensuche. Personenbezogene Daten bleiben auf dem Server der Behörde.

  • Bildung

    Lerninhalte und ein interner Wissensassistent. Schülerdaten bleiben in der Schule.

  • Handel und E-Commerce

    Produktkatalog, Kundenservice, Rückgaberegeln. Kundendaten bleiben bei Ihnen.

Ihre Branche fehlt? Schreiben Sie uns; sprechen wir zuerst über Ihr Geschäft und Ihre Daten.Angebot anfordern

Zusammenarbeit

Vom ersten Gespräch zum laufenden Modell

Dauer und Preis hängen von Ihrem Geschäft und Ihren Daten ab; nach dem Erstgespräch erhalten Sie ein schriftliches Angebot.

  1. 1. Erstgespräch

    Wir sprechen über Ihr Geschäft, Ihre Daten und Ihre Datenschutzanforderungen.

  2. 2. Datenbestand und Testset

    Wir legen fest, welche Dokumente und Datensätze genutzt werden, und bauen ein Testset aus Ihren echten Fragen.

  3. 3. Pilotmodell

    Wir vergleichen Kandidaten für das Basismodell, passen den Gewinner per Feinabstimmung an und geben Ihnen den Messbericht.

  4. 4. Installation

    Wir installieren das Modell auf Ihrem eigenen Server oder einer nur für Sie gemieteten GPU und binden es an Ihre Systeme an.

  5. 5. Wartung und neue Versionen

    Wir aktualisieren das Modell mit neuen Dokumenten und Fragen und messen jede Version erneut.

Server- und Rechenzentrumsaufbau (F09)

Angebot

Beschreiben Sie Ihre Branche und Ihre Daten – wir erstellen Ihnen ein Angebot für Ihr eigenes Modell.

Schreiben Sie kurz, was Sie tun und welche Daten Sie haben; wir melden uns für ein Erstgespräch.

Wählen Sie die Linie, die Sie interessiert

Die aktuelle Situation und das gewünschte Ergebnis genügen.

Ihre Nachricht geht direkt an unser Team. Damit sie bei der richtigen Linie landet, wird der Nachrichtentext per KI vorsortiert; Ihr Name und Ihre Kontaktdaten werden dabei nicht übermittelt.