跳到正文

BALASAGUN · BRAINSTORM 自己的语言模型

Balasagun:《福乐智慧》之城

Balasagun(八剌沙衮)是喀喇汗王朝的都城之一,位于楚河流域,在今天的吉尔吉斯斯坦境内。《福乐智慧》(Kutadgu Bilig)的作者玉素甫·哈斯·哈吉甫生于此城,并在这里开始创作;1069–70 年,他在喀什噶尔完成了这部作品。

Kutadgu Bilig 意为“获得幸福的知识”。我们的模型以这座城市命名。

打造您自己的语言模型。

一个专属于您的人工智能语言模型,驻留并运行在您自己的服务器或租用的 GPU 上。它讲的是您业务的语言;除非您另有选择,您的问题和文档不会发送给其他人工智能公司。

状态

开发中 · 阶段 0 / 3 · 2026 年 10 月

如何运作

模型驻留在您的服务器上

您的服务器 · 或租用的 GPU011011001001101101外部人工智能服务✕您的系统PMS · ERP · SCADA您的文档法规 · 政策BALASAGUN在您的服务器上BALASAGUN工具计算 · 工单用户304 号房的空调不能用了。304 号房 · 维护记录开立工单:空调,304 号房已向技术部开立工单,维修人员正在前往房间。住宅的安装功率为 12 kW。需用功率是多少?土耳其《电气内部装置条例》第 57 条 · 同时系数8 kW × 0.6 + 4 kW × 0.4需用功率:6.4 kW。来源:《内部装置条例》第 57 条

动画:展示预期的工作方式。模型仍在开发中。

酒店

  1. 住客给前台留言:“304 号房的空调不能用了。”
  2. BALASAGUN 运行在酒店自己的服务器上;问题不会发给其他公司。
  3. 它查阅房间的维护记录和酒店系统。
  4. 它为技术部开立工单。
  5. 回答返回给住客;工单已交到技术部。

电气

  1. 工程师提问:“住宅的安装功率为 12 kW,需用功率是多少?”
  2. 模型在您的服务器上思考。
  3. 它从条例原文中读取同时系数规则,而不是凭记忆。
  4. 它用工具计算:前 8 kW 取 0.6,其余部分取 0.4。
  5. 回答连同来源一起返回:需用功率为 6.4 kW。
  1. 1 · 问题到达住客、员工或工程师提问
  2. 2 · 模型思考在您的服务器上,不经过其他公司
  3. 3 · 查阅来源法规、维护记录、酒店政策
  4. 4 · 执行操作计算,开立工单
  5. 5 · 返回回答连同来源一起

什么是 BALASAGUN?

面向电气工程和酒店的自有语言模型

BALASAGUN 是我们目前正针对电气工程和酒店管理训练的自有人工智能语言模型。我们不从零开始训练:我们以开源语言模型为基础,凭借自己的工程经验,按目标行业的需要进行训练,然后投入服务并运行。因此,我们无需使用昂贵的语言模型,而是用自己的语言模型打造解决方案。同时,我们为您开发的专属大语言模型(LLM),也可以配置为与您选择的其他 LLM 混合协同运行。

  • 酒店管理

    住客咨询、技术服务、能源与维护跟踪、员工事务。酒店自己的规定和价格,每次提问时都从其文档中读取。

  • 电气工程

    土耳其关于电气内部装置、接地和强电设施的条例;电压降、需用功率、勘察与工程量计算。

  • 首批用户:我们自己的产品

    Elektrik GPT 勘察软件、本站助手 Leyla 和 ARI 能源监测,将是首批使用 BALASAGUN 的产品。

    Elektrik GPT能源平台

我们的做法

五步打造您的模型

每个模型都经过同样的五个步骤。我们正是这样训练 BALASAGUN 的,也会用同样的方法搭建您的模型。

如何成长

从开源模型到您的模型

您的专属环境✓✓✓我们的测试集基础模型适配后的模型目标:基础 + 至少 10 分开源模型Apache 2.0您的知识专家审核GPU · 微调LoRA您自己的服务器租用 GPU为您专用
  1. 选定一个允许商用(Apache 2.0)的基础模型。不从零开始训练。
  2. 加入法规、您自己的文档和经专家审核的规则;每条记录的来源都可追溯。
  3. 在 GPU 上用 LoRA 微调:模型学会您业务的语言。
  4. 在我们自己的测试集上检验。如果不能超过基础模型,就不上线。
  5. 安装到您自己的服务器,或为您专用的租用 GPU 上。
  1. 1 · 选定开源模型Apache 2.0,允许商用;许可证信息从模型卡中读取
  2. 2 · 加入您的知识法规、您的文档、经专家审核的规则;每条记录的来源都可追溯
  3. 3 · 在 GPU 上微调LoRA;不从零开始训练
  4. 4 · 考核我们自己的测试集;如果不能超过基础模型,就不上线
  5. 5 · 安装到您的服务器您自己的服务器或为您专用的租用 GPU;如需处理个人数据,我们建议使用您自己的服务器

我们的承诺

四项承诺

  • 数据由您掌控

    模型在您自己的服务器或为您专用的租用 GPU 上训练和运行。对于将处理个人数据的模型,我们建议使用您自己的服务器。向其他人工智能公司的云端模型发送请求,仅限于您选定的任务,并且只在您需要时进行。

  • 许可明确的模型,来源可追溯的数据

    基础模型一律采用允许商用的许可证(Apache 2.0 / MIT)。每条训练记录都保留来源和许可说明,必要时可用一条命令将其从训练中移除。

  • 不死记硬背

    价格、条款编号、政策等会变化的信息,不让模型死记;每次提问时都从文档中读取。信息变化时,无需重新训练模型。

  • 未经测评,不上线

    每个版本都在我们自己的测试集上与基础模型对比;未能超过基础模型的版本不会被使用。我们为 BALASAGUN 第一个版本设定的目标:总分至少提高 10 分,且任何领域的下降都不超过 2 分。

我们目前的进展

如实的现状

第一个版本尚未训练;我们会随着进展更新本节内容。

  1. 0当前

    测试集与基础模型比选

  2. 1

    数据管线

  3. 2

    训练第一个版本(v0.1)

  4. 3

    服务部署与集成

  5. v1

    扩展版本

训练基础设施

BALASAGUN 训练模型

迄今为止的进展,附真实记录:基础模型比选与首次 LoRA 试训练。正式训练是下一步;这里如实展示实际发生的情况。

基础模型比选

五个开源模型在我们自有测试集的 50 道题(25 道电气、25 道酒店)上同场比拼,由一个开放权重的评审模型为回答打分。选定的基础模型是 Qwen3.6-35B-A3B:电气领域排名第一,采用 Apache-2.0 许可证,并且适合在一块 GPU 上同时为两个领域适配器提供服务。

模型总分电气酒店
google/gemma-4-26B-A4B-it87.276.098.4
Qwen/Qwen3.6-35B-A3B已选定84.686.482.8
google/gemma-4-12B-it79.664.095.2
Qwen/Qwen3.5-9B73.872.475.2
mistralai/Mistral-Small-3.2-24B-Instruct-250664.655.274.0

满分 100 · 评审:Qwen3.8-27B · 2026 年 10 月 19 日
首次 LoRA 试训练

在正式训练之前,我们对整套流程做了端到端测试:在同一个基础模型上,两个 LoRA 适配器(电气、酒店)各训练了 20 步。训练运行成功;随后用 vLLM 提供服务的步骤在这次试验中崩溃了,正在修复。

GPU
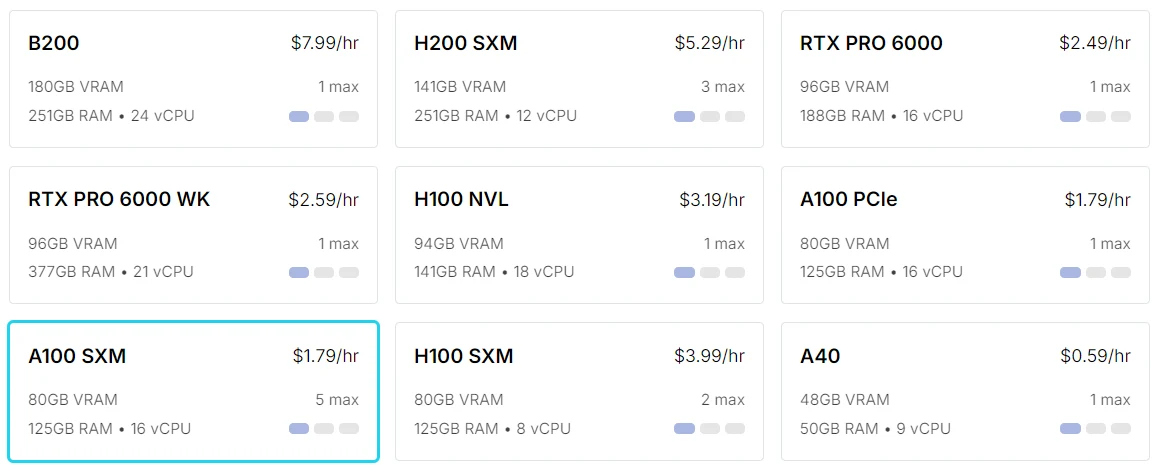
NVIDIA A100 SXM 80 GB(租用,RunPod)
VRAM 占用
69.3 GB(峰值 69.6 GB)
模型加载
228 秒
训练
2 个适配器 × 20 步,42 秒
训练参数量
每个适配器 3,440,640 个(LoRA r=16)
损失(Loss)
电气 3.89 → 0.88 · 酒店 2.13 → 0.31
Pod 运行时长
17 分钟;任务结束后即删除
摘自 pod 日志(原样)
15:18:59Z {"olay": "yuklendi", "sn": 228.0, "vram_gb": 69.3, "sinif": "Qwen3_5MoeForCausalLM"}
15:19:00Z {"olay": "adaptor", "adaptor": "elektrik", "egitilebilir": 3440640}
15:19:03Z {"olay": "adim", "adaptor": "elektrik", "adim": 0, "loss": 3.892}
15:19:22Z {"olay": "adim", "adaptor": "elektrik", "adim": 19, "loss": 0.8816}
15:19:22Z {"olay": "adaptor", "adaptor": "otel", "egitilebilir": 3440640}
15:19:23Z {"olay": "adim", "adaptor": "otel", "adim": 0, "loss": 2.1289}
15:19:41Z {"olay": "adim", "adaptor": "otel", "adim": 19, "loss": 0.306}
15:19:42Z {"olay": "egitim_bitti", "sn": 270.4, "vram_gb_max": 69.6}
15:20:00Z vLLM version 0.31.0 · model Qwen/Qwen3.6-35B-A3B · lora_modules: elektrik, otel
Durum: BAŞARISIZ — vLLM kapandı (vllm-exited) · GPU: NVIDIA A100-SXM4-80GB · süre: 17 dk

时间为 UTC。这些行是我们训练脚本自身的日志。

来自 RunPod 控制台

RunPod 控制台中的 GPU 卡片;A100 SXM 80 GB VRAM 卡片已高亮显示。
GPU 选择:试训练在 A100 SXM 80 GB 上运行(高亮处)。价格和库存为实时数值。
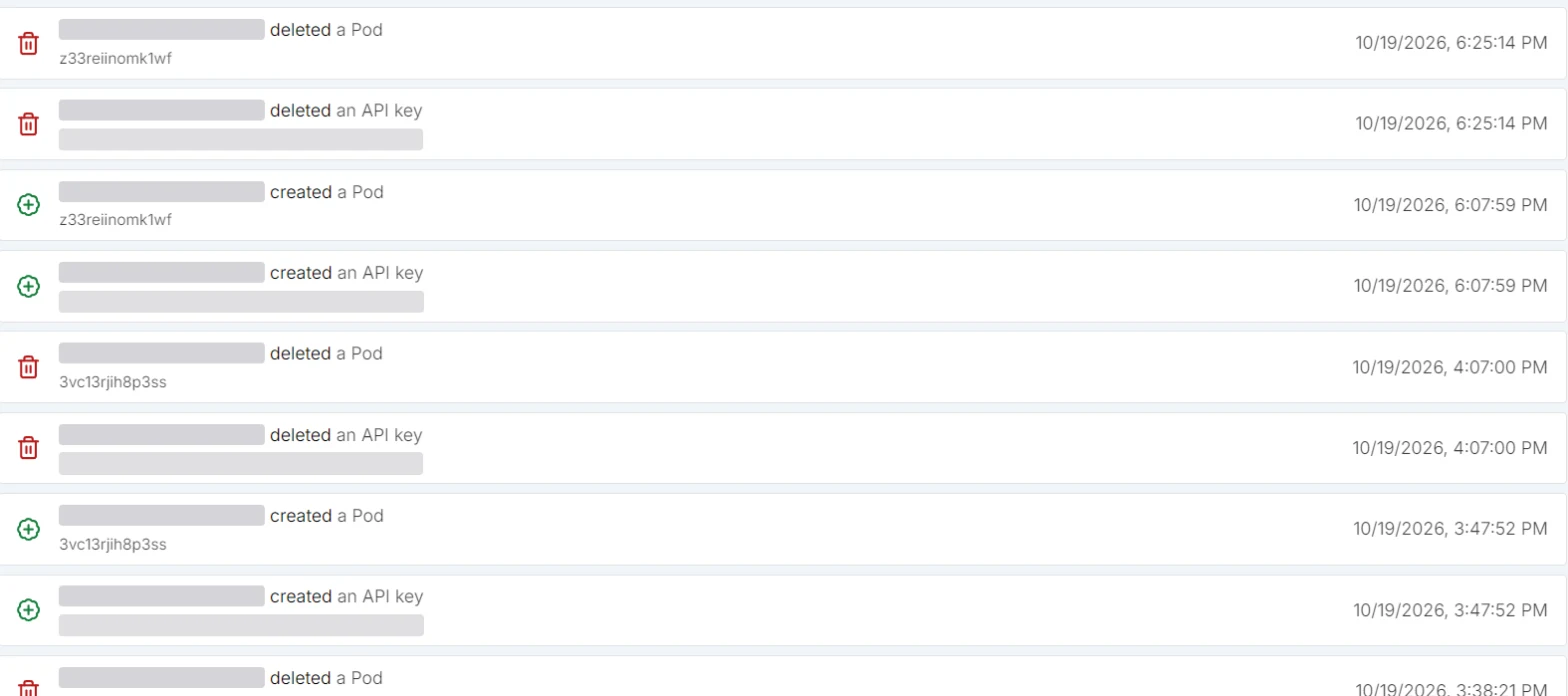
RunPod 审计日志,含 pod 创建和删除记录;电子邮件和密钥 ID 已遮盖。
审计日志:试验 pod 于 18:07 创建,18:25 删除(土耳其时间)。账户信息已遮盖。

我们使用的软件

  • Qwen3.6-35B-A3B

    基础模型(Apache-2.0)

  • PyTorch + Hugging Face Transformers

    加载和训练模型

  • PEFT (LoRA)

    领域适配器(电气、酒店)

  • vLLM 0.31.0

    评估与提供服务(OpenAI 兼容接口)

  • RunPod GPU 实例

    租用的 A100 80 GB 和 RTX A6000 48 GB 服务器

  • Hugging Face Hub

    存放模型和适配器的私有仓库

  • Python 3.12 + uv

    数据管线、测试集和评分器

  • 成本守卫 + Oracle 清理程序

    任务结束后 pod 自动关闭;被遗忘的 pod 在 1.5 小时后删除

下一步:正式训练

用经专家审核的数据进行 bf16 LoRA 训练,在 80–96 GB 的 GPU 上进行(A100 80 GB 或 RTX PRO 6000 96 GB)。每个适配器都用其所属领域的测试集测评;未能超过基础模型的版本不上线。

面向您的行业

我们也可以为您的行业搭建。

就像我们为自己打造 BALASAGUN 一样,我们也会为您的行业搭建并训练您自己的语言模型:运行在您自己的服务器或租用的 GPU 上。

  • 医疗

    患者信息说明,检索诊疗方案和药物指南。患者数据保留在医院的服务器上。

  • 法律

    案卷档案与判例检索,起草诉状。委托人的案卷保留在律所内。

  • 财务与会计

    发票识读、法规问答、往来账汇总。财务记录保留在公司的服务器上。

  • 制造与工厂

    设备手册、维护记录、故障诊断。生产数据保留在工厂内。

  • 能源与基础设施

    现场报告、故障记录、设施文档。电网和设施数据保留在您手中。

  • 公共部门与市政

    答复市民申请,检索法规。个人数据保留在机构的服务器上。

  • 教育

    课程内容和内部知识助手。学生数据保留在学校。

  • 零售与电子商务

    商品目录、客户服务、退货规则。客户数据保留在您手中。

您的行业不在列表中?请来信;我们先谈谈您的业务和数据。索取报价

如何合作

从第一次沟通到投入运行的模型

工期和价格取决于您的业务和数据;需求沟通会之后,我们会提供书面报价。

  1. 1. 需求沟通会

    我们了解您的业务、数据和保密要求。

  2. 2. 数据清单与测试集

    我们梳理将使用哪些文档和记录,并用您的真实问题建立测试集。

  3. 3. 试点模型

    我们让候选基础模型同场比拼,通过微调适配胜出者,并向您提交测评报告。

  4. 4. 安装部署

    我们把模型安装到您自己的服务器或为您专用的租用 GPU 上,并与您的系统对接。

  5. 5. 维护与新版本

    我们用新的文档和问题更新模型,并对每个版本重新测评。

服务器与数据中心建设(F09)

索取报价

介绍您的行业和数据;我们为您准备专属模型的报价。

请简要写下您的业务和现有的数据;我们会回复您,安排需求沟通会。

请选择您感兴趣的线路

描述当前情况和您想要的结果即可。

您的消息会直接发送给我们的团队。为便于转给合适的业务线,消息正文会先经过人工智能预分类;您的姓名和联系方式不会发送到这一步。