Vai al contenuto

BALASAGUN · il modello linguistico di BRAINSTORM

Balasagun: la città del Kutadgu Bilig

Balasagun fu una delle capitali dei Karakhanidi, nel bacino del fiume Chu, nell'odierno Kirghizistan. Yusuf Has Hacib, autore del Kutadgu Bilig, nacque in questa città e qui iniziò la sua opera; la completò a Kashgar nel 1069–70.

Kutadgu Bilig significa «la conoscenza dell'essere felici». Il nostro modello prende il nome da questa città.

Create il vostro modello linguistico.

Un modello linguistico di IA fatto per voi, che vive e lavora sul vostro server o su GPU a noleggio. Parla la lingua della vostra attività; a meno che non decidiate diversamente, le vostre domande e i vostri documenti non vanno mai a un'altra azienda di IA.

Stato

In sviluppo · Fase 0 / 3 · ottobre 2026

Come funziona

Il modello vive sul vostro server

IL VOSTRO SERVER · o GPU a noleggio011011001001101101SERVIZIO DI IA ESTERNO✕I VOSTRI SISTEMIPMS · ERP · SCADAI VOSTRI DOCUMENTInorme · policyBALASAGUNsul vostro serverBALASAGUNSTRUMENTIcalcoli · ordini di lavoroUTENTICamera 304: l'aria condizionatanon funziona.camera 304 · registro manutenzioneordine di lavoro: clima, camera 304Ordine di lavoro aperto;la squadra sta andando in camera.Appartamento con 12 kW installati.Qual è la potenza contemporanea?Regolamento impianti elettriciart. 57 · contemporaneità8 kW × 0,6 + 4 kW × 0,4Potenza contemporanea: 6,4 kW.Fonte: Regolamento impianti, art. 57

Animazione: il funzionamento previsto. Il modello è ancora in fase di sviluppo.

HOTEL

  1. Un ospite scrive alla reception: «In camera 304 l'aria condizionata non funziona».
  2. BALASAGUN funziona sul server dell'hotel; la domanda non va a nessun'altra azienda.
  3. Consulta il registro di manutenzione della camera e il sistema dell'hotel.
  4. Apre un ordine di lavoro per il servizio tecnico.
  5. La risposta torna all'ospite; l'ordine di lavoro passa al servizio tecnico.

ELETTRICO

  1. Un ingegnere chiede: «L'appartamento ha 12 kW di potenza installata. Qual è la potenza contemporanea?»
  2. Il modello ragiona sul vostro server.
  3. Legge la regola di contemporaneità nel regolamento stesso, non a memoria.
  4. Calcola con uno strumento: 0,6 per i primi 8 kW, 0,4 per il resto.
  5. La risposta torna con la sua fonte: una potenza contemporanea di 6,4 kW.
  1. 1 · Arriva una domandachiede un ospite, un membro del personale o un ingegnere
  2. 2 · Il modello ragionasul vostro server, senza passare da un'altra azienda
  3. 3 · Consulta la fonteregolamento, registro di manutenzione, policy dell'hotel
  4. 4 · Agiscecalcola, apre un ordine di lavoro
  5. 5 · Torna la rispostainsieme alla sua fonte

Che cos'è BALASAGUN?

Il nostro modello linguistico per l'ingegneria elettrica e gli hotel

BALASAGUN è il modello linguistico di IA che stiamo addestrando in questo momento per l'ingegneria elettrica e la gestione alberghiera. Non addestriamo da zero: prendiamo modelli linguistici open source, li addestriamo con la nostra esperienza di ingegneria in base al settore richiesto, li mettiamo in servizio e li facciamo funzionare. Così, invece di usare costosi modelli linguistici, creiamo soluzioni con il nostro modello linguistico. Possiamo inoltre configurare il vostro LLM, che svilupperemo per voi, in modo che lavori in modalità ibrida con gli altri LLM che preferite.

  • Gestione alberghiera

    Domande degli ospiti, servizio tecnico, monitoraggio di energia e manutenzione, compiti del personale. Le regole e i prezzi propri dell'hotel vengono letti dai suoi documenti a ogni domanda.

  • Ingegneria elettrica

    Regolamenti turchi su impianti elettrici interni, messa a terra e impianti di potenza (correnti forti); calcoli di caduta di tensione, potenza contemporanea, rilievo e computo.

  • Primi utenti: i nostri prodotti

    Il software di rilievo Elektrik GPT, Leyla, l'assistente di questo sito, e la piattaforma di monitoraggio energetico ARI saranno i primi prodotti a usare BALASAGUN.

    Elektrik GPTPiattaforma Energia

Come lo facciamo

Il vostro modello in cinque passi

Ogni modello segue gli stessi cinque passi. È così che stiamo addestrando BALASAGUN, ed è così che realizziamo il vostro.

Come cresce

Da un modello aperto al vostro modello

IL VOSTRO AMBIENTE DEDICATO✓✓✓IL NOSTRO SET DI TESTmodello basemodello adattatoobiettivo: base + 10 pt o piùMODELLO APERTOApache 2.0LE VOSTRE CONOSCENZEapprovate da espertiGPU · FINE-TUNINGLoRAIL VOSTRO SERVERGPU A NOLEGGIOdedicata a voi
  1. Si sceglie un modello base con licenza per uso commerciale (Apache 2.0). Nessun addestramento da zero.
  2. Si aggiungono normative, i vostri documenti e regole approvate da esperti; la fonte di ogni record resta tracciata.
  3. Fine-tuning con LoRA su GPU: il modello impara la lingua della vostra attività.
  4. Viene verificato sul nostro set di test. Se non batte il modello base, non va in produzione.
  5. Viene installato sul vostro server o su una GPU a noleggio dedicata a voi.
  1. 1 · Si sceglie un modello apertoApache 2.0, con licenza per uso commerciale; la licenza si legge nella scheda del modello
  2. 2 · Si aggiungono le vostre conoscenzenormative, i vostri documenti, regole approvate da esperti; la fonte di ogni record resta tracciata
  3. 3 · Fine-tuning su GPULoRA; nessun addestramento da zero
  4. 4 · L'esameil nostro set di test; se non batte il modello base, non va in produzione
  5. 5 · Installazione da voiil vostro server o una GPU a noleggio dedicata a voi; per i dati personali consigliamo il vostro server

I nostri impegni

Quattro impegni

  • I vostri dati sotto il vostro controllo

    Il modello viene addestrato e funziona sul vostro server o su una GPU a noleggio dedicata a voi. Per i modelli che tratteranno dati personali consigliamo il vostro server. Le richieste al modello cloud di un'altra azienda di IA partono solo per le attività che scegliete voi, e solo se lo desiderate.

  • Un modello con licenza chiara, dati tracciabili

    Il modello base ha sempre una licenza per uso commerciale (Apache 2.0 / MIT). Ogni record di addestramento conserva la fonte e la nota di licenza, e si può togliere dall'addestramento con un solo comando.

  • Niente memorizzazione

    Le informazioni che cambiano, come prezzi, numeri di articolo e policy, non vengono mai memorizzate dal modello; si leggono dal documento a ogni domanda. Quando le informazioni cambiano, non serve riaddestrare il modello.

  • Nessun rilascio senza misurazione

    Ogni versione viene confrontata con il modello base sul nostro set di test; una versione che non lo batte non viene usata. Il nostro obiettivo per la prima versione di BALASAGUN: almeno 10 punti in più nel complesso e nessuna area peggiorata di oltre 2 punti.

A che punto siamo

Lo stato reale

La prima versione non è ancora stata addestrata; aggiorniamo questa sezione man mano che andiamo avanti.

  1. 0ora

    Set di test e gara tra modelli base

  2. 1

    Pipeline dei dati

  3. 2

    Addestramento della prima versione (v0.1)

  4. 3

    Messa in servizio e integrazione

  5. v1

    Versione estesa

Infrastruttura di addestramento

Il modello di addestramento di BALASAGUN

Ciò che abbiamo fatto finora, con i registri reali: la gara tra modelli base e il primo addestramento di prova con LoRA. L'addestramento completo è il prossimo passo; qui mostriamo esattamente cosa è successo.

Gara tra modelli base

Cinque modelli open source si sono confrontati su 50 domande del nostro set di test (25 di ambito elettrico, 25 di ambito alberghiero); un modello giudice a pesi aperti ha valutato le risposte. Come base abbiamo scelto Qwen3.6-35B-A3B: primo in ingegneria elettrica, con licenza Apache-2.0 e adatto a servire insieme i due adattatori di dominio su una sola GPU.

ModelloTotaleElettricoHotel
google/gemma-4-26B-A4B-it87,276,098,4
Qwen/Qwen3.6-35B-A3Bscelto84,686,482,8
google/gemma-4-12B-it79,664,095,2
Qwen/Qwen3.5-9B73,872,475,2
mistralai/Mistral-Small-3.2-24B-Instruct-250664,655,274,0

Punteggi su 100 · giudice: Qwen3.8-27B · 19 ottobre 2026
Primo addestramento di prova con LoRA

Prima dell'addestramento completo abbiamo provato l'intera configurazione dall'inizio alla fine: due adattatori LoRA (elettrico, hotel) sono stati addestrati per 20 passi ciascuno sulla stessa base. L'addestramento ha funzionato; il passo successivo, la messa in servizio con vLLM, in questa prova si è interrotto con un errore ed è in corso di correzione.

GPU
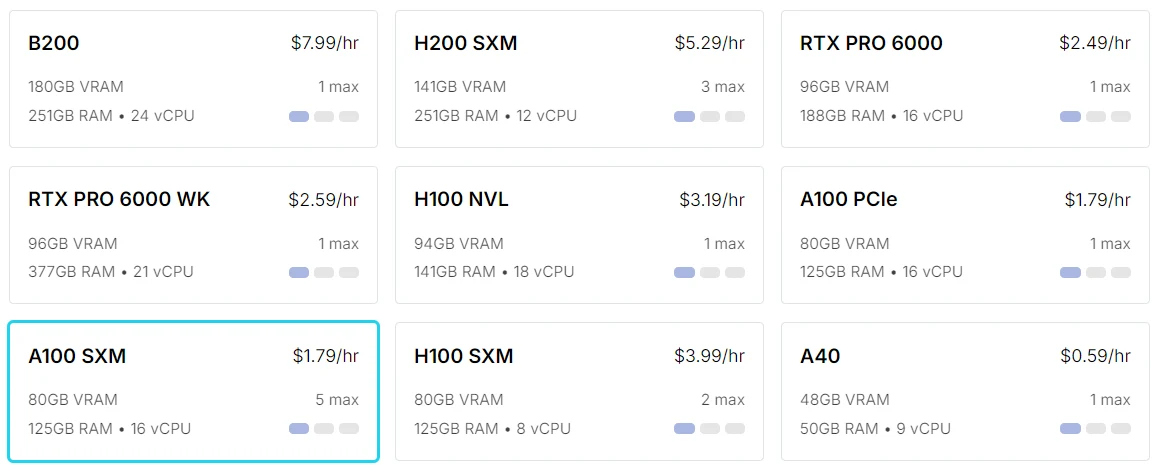
NVIDIA A100 SXM 80 GB (a noleggio, RunPod)
VRAM utilizzata
69,3 GB (picco 69,6 GB)
Caricamento del modello
228 s
Addestramento
2 adattatori × 20 passi, 42 s
Parametri addestrati
3.440.640 per adattatore (LoRA r=16)
Loss
elettrico 3,89 → 0,88 · hotel 2,13 → 0,31
Durata del pod
17 min; eliminato a fine lavoro
Dal log del pod (così com'è)
15:18:59Z {"olay": "yuklendi", "sn": 228.0, "vram_gb": 69.3, "sinif": "Qwen3_5MoeForCausalLM"}
15:19:00Z {"olay": "adaptor", "adaptor": "elektrik", "egitilebilir": 3440640}
15:19:03Z {"olay": "adim", "adaptor": "elektrik", "adim": 0, "loss": 3.892}
15:19:22Z {"olay": "adim", "adaptor": "elektrik", "adim": 19, "loss": 0.8816}
15:19:22Z {"olay": "adaptor", "adaptor": "otel", "egitilebilir": 3440640}
15:19:23Z {"olay": "adim", "adaptor": "otel", "adim": 0, "loss": 2.1289}
15:19:41Z {"olay": "adim", "adaptor": "otel", "adim": 19, "loss": 0.306}
15:19:42Z {"olay": "egitim_bitti", "sn": 270.4, "vram_gb_max": 69.6}
15:20:00Z vLLM version 0.31.0 · model Qwen/Qwen3.6-35B-A3B · lora_modules: elektrik, otel
Durum: BAŞARISIZ — vLLM kapandı (vllm-exited) · GPU: NVIDIA A100-SXM4-80GB · süre: 17 dk

Orari in UTC. Le righe sono il log del nostro script di addestramento.

Dalla console di RunPod

Schede GPU nella console di RunPod; la scheda A100 SXM con 80 GB di VRAM è evidenziata.
Scelta della GPU: l'addestramento di prova è stato eseguito su una A100 SXM 80 GB (evidenziata). Prezzi e disponibilità sono valori in tempo reale.
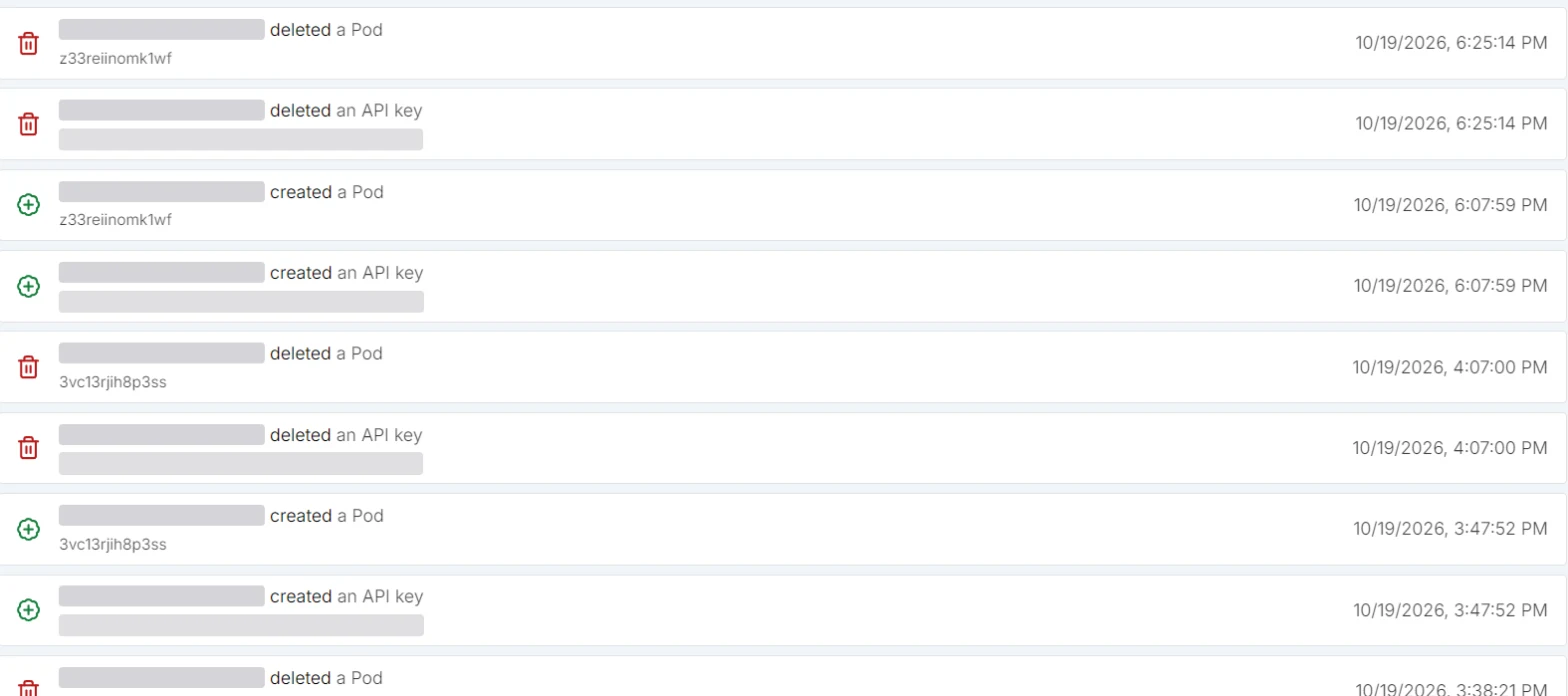
Registro di audit di RunPod con le righe di creazione ed eliminazione del pod; e-mail e ID delle chiavi sono oscurati.
Registro di audit: il pod di prova è stato creato alle 18:07 ed eliminato alle 18:25 (ora turca). I dati dell'account sono oscurati.

Il software che usiamo

  • Qwen3.6-35B-A3B

    modello base (Apache-2.0)

  • PyTorch + Hugging Face Transformers

    caricamento e addestramento del modello

  • PEFT (LoRA)

    adattatori di dominio (elettrico, hotel)

  • vLLM 0.31.0

    valutazione e messa in servizio (endpoint compatibile con OpenAI)

  • Pod GPU di RunPod

    server a noleggio con A100 80 GB e RTX A6000 48 GB

  • Hugging Face Hub

    repository privati per modelli e adattatori

  • Python 3.12 + uv

    pipeline dei dati, set di test e valutatori

  • Guardiano dei costi + pulitore Oracle

    il pod si spegne a fine lavoro; un pod dimenticato viene eliminato dopo 1,5 ore

Prossimo passo: l'addestramento completo

Addestramento LoRA in bf16 con dati approvati da esperti, su una GPU da 80–96 GB (A100 80 GB o RTX PRO 6000 96 GB). Ogni adattatore viene misurato sul set di test del proprio dominio; una versione che non batte il modello base non va in produzione.

Per il vostro settore

Possiamo realizzarne uno anche per il vostro settore.

Come abbiamo fatto con BALASAGUN per noi, configuriamo e addestriamo il vostro modello linguistico per il vostro settore: sul vostro server o su GPU a noleggio.

  • Sanità

    Informazioni ai pazienti, ricerca in protocolli e prontuari farmaceutici. I dati dei pazienti restano sul server dell'ospedale.

  • Settore legale

    Archivio delle pratiche e ricerca giurisprudenziale, bozze di atti. I fascicoli dei clienti restano nello studio.

  • Finanza e contabilità

    Lettura delle fatture, domande sulla normativa, riepiloghi dei conti. I dati contabili restano sul server dell'azienda.

  • Manifattura

    Manuali delle macchine, registri di manutenzione, diagnosi dei guasti. I dati di produzione restano in fabbrica.

  • Energia e infrastrutture

    Rapporti dal campo, registri dei guasti, documentazione degli impianti. I dati di rete e degli impianti restano da voi.

  • Pubblica amministrazione e comuni

    Risposte alle richieste dei cittadini, ricerca normativa. I dati personali restano sul server dell'ente.

  • Istruzione

    Contenuti dei corsi e un assistente per le conoscenze interne. I dati degli studenti restano nella scuola.

  • Commercio al dettaglio ed e-commerce

    Catalogo prodotti, assistenza clienti, regole sui resi. I dati dei clienti restano da voi.

Il vostro settore non è in elenco? Scriveteci; parliamo prima della vostra attività e dei vostri dati.Richiedi un preventivo

Come lavoriamo insieme

Dal primo colloquio a un modello funzionante

Tempi e prezzo dipendono dalla vostra attività e dai vostri dati; dopo l'incontro conoscitivo vi inviamo un preventivo scritto.

  1. 1. Incontro conoscitivo

    Parliamo della vostra attività, dei vostri dati e dei vostri requisiti di riservatezza.

  2. 2. Inventario dei dati e set di test

    Definiamo quali documenti e registrazioni verranno usati e costruiamo un set di test con le vostre domande reali.

  3. 3. Modello pilota

    Mettiamo a confronto i modelli base candidati, adattiamo il vincitore con il fine-tuning e vi consegniamo il rapporto di misurazione.

  4. 4. Installazione

    Installiamo il modello sul vostro server o su una GPU a noleggio dedicata a voi e lo colleghiamo ai vostri sistemi.

  5. 5. Manutenzione e nuove versioni

    Aggiorniamo il modello con nuovi documenti e domande e misuriamo di nuovo ogni versione.

Realizzazione di server e data center (F09)

Richiesta di preventivo

Descriveteci il vostro settore e i vostri dati; prepareremo un preventivo per il vostro modello.

Scriveteci in breve della vostra attività e dei dati di cui disponete; vi ricontatteremo per fissare un incontro conoscitivo.

Scegli la linea che ti interessa

Basta descrivere la situazione attuale e il risultato che cerchi.

Il tuo messaggio arriva direttamente al nostro team. Per indirizzarlo alla linea giusta, il testo del messaggio viene preclassificato con l'IA; nome e dati di contatto non vengono inviati a questa fase.