Naar de inhoud

BALASAGUN · het eigen taalmodel van BRAINSTORM

Balasagun: de stad van de Kutadgu Bilig

Balasagun was een van de hoofdsteden van de Karachaniden, in het stroomgebied van de rivier de Tsjoe, in het huidige Kirgizië. Yusuf Has Hacib, de auteur van de Kutadgu Bilig, werd in deze stad geboren en begon hier aan zijn werk; hij voltooide het in 1069–70 in Kashgar.

Kutadgu Bilig betekent “de kennis van het gelukkig zijn”. Ons model ontleent zijn naam aan deze stad.

Creëer uw eigen taalmodel.

Een AI-taalmodel speciaal voor u, dat op uw eigen server of op gehuurde GPU's leeft en werkt. Het spreekt de taal van uw bedrijf; tenzij u anders kiest, gaan uw vragen en documenten nooit naar een ander AI-bedrijf.

Status

In ontwikkeling · Fase 0 / 3 · oktober 2026

Zo werkt het

Het model leeft op uw server

UW SERVER · of gehuurde GPU011011001001101101EXTERNE AI-DIENST✕UW SYSTEMENPMS · ERP · SCADAUW DOCUMENTENregelgeving · beleidBALASAGUNop uw serverBALASAGUNTOOLSberekeningen · werkordersGEBRUIKERSKamer 304: de airconditioningwerkt niet.kamer 304 · onderhoudslogwerkorder aanmaken: airco, kamer 304Er is een werkorder aangemaakt;het team is onderweg.Woning: 12 kW geïnstalleerd vermogen.Wat is het gevraagde vermogen?Verordening elektr. installatiesart. 57 · gelijktijdigheidsfactoren8 kW × 0,6 + 4 kW × 0,4Gevraagd vermogen: 6,4 kW.Bron: Installatieverordening, art. 57

Animatie: zo moet het gaan werken. Het model is nog in ontwikkeling.

HOTEL

  1. Een gast schrijft naar de receptie: “De airconditioning in kamer 304 werkt niet.”
  2. BALASAGUN draait op de eigen server van het hotel; de vraag gaat naar geen enkel ander bedrijf.
  3. Het controleert het onderhoudslog van de kamer en het hotelsysteem.
  4. Het maakt een werkorder aan voor de technische dienst.
  5. Het antwoord gaat terug naar de gast; de werkorder ligt bij de technische dienst.

ELEKTROTECHNIEK

  1. Een ingenieur vraagt: “De woning heeft 12 kW geïnstalleerd vermogen. Wat is het gevraagde vermogen?”
  2. Het model denkt na op uw server.
  3. Het leest de gelijktijdigheidsregel uit de verordening zelf, niet uit het geheugen.
  4. Het rekent met een tool: 0,6 voor de eerste 8 kW, 0,4 voor de rest.
  5. Het antwoord komt terug met de bron: een gevraagd vermogen van 6,4 kW.
  1. 1 · Er komt een vraageen gast, medewerker of ingenieur vraagt
  2. 2 · Het model denkt naop uw server, zonder via een ander bedrijf te gaan
  3. 3 · Het raadpleegt de bronregelgeving, onderhoudslog, hotelbeleid
  4. 4 · Het handeltrekent, maakt een werkorder aan
  5. 5 · Het antwoord komt terugsamen met de bron

Wat is BALASAGUN?

Ons eigen taalmodel voor elektrotechniek en hotels

BALASAGUN is het AI-taalmodel dat we op dit moment trainen voor elektrotechniek en hotelmanagement. We trainen niet vanaf nul: we nemen taalmodellen met open broncode, trainen ze met onze eigen technische kennis voor de gewenste sector, en nemen ze daarna in gebruik en houden ze draaiende. Zo bouwen we oplossingen met ons eigen taalmodel, in plaats van dure taalmodellen te gebruiken. Daarnaast kunnen we uw eigen LLM, dat we in uw opdracht ontwikkelen, zo inrichten dat het hybride samenwerkt met andere LLM's naar uw keuze.

  • Hotelmanagement

    Vragen van gasten, technische dienst, het bijhouden van energie en onderhoud, personeelstaken. De eigen regels en prijzen van het hotel worden bij elke vraag uit de documenten gelezen.

  • Elektrotechniek

    Turkse regelgeving voor elektrische installaties, aarding en sterkstroominstallaties; berekeningen van spanningsval, gevraagd vermogen, calculatie en hoeveelheden.

  • Eerste gebruikers: onze eigen producten

    De calculatiesoftware Elektrik GPT, Leyla, de assistent op deze website, en ARI Energiemonitoring worden de eerste producten die BALASAGUN gebruiken.

    Elektrik GPTEnergieplatform

Hoe we het doen

Uw model in vijf stappen

Elk model doorloopt dezelfde vijf stappen. Zo trainen we BALASAGUN, en zo bouwen we ook het uwe.

Zo groeit het

Van open model naar uw model

UW EIGEN OMGEVING✓✓✓ONZE TESTSETbasismodelaangepast modeldoel: basis + min. 10 puntenOPEN MODELApache 2.0UW KENNISdoor experts goedgekeurdGPU · FINETUNINGLoRAUW EIGEN SERVERGEHUURDE GPUalleen voor u
  1. Er wordt een basismodel met een licentie voor commercieel gebruik (Apache 2.0) gekozen. Geen training vanaf nul.
  2. Regelgeving, uw eigen documenten en door experts goedgekeurde regels komen erbij; van elk record wordt de bron bijgehouden.
  3. Finetuning met LoRA op een GPU: het model leert de taal van uw bedrijf.
  4. Het wordt getest op onze eigen testset. Verslaat het het basismodel niet, dan gaat het niet live.
  5. Het wordt geïnstalleerd op uw eigen server of op een gehuurde GPU die alleen voor u is.
  1. 1 · Een open model kiezenApache 2.0, commercieel bruikbaar; de licentie lezen we af van de modelkaart
  2. 2 · Uw kennis erbijregelgeving, uw documenten, door experts goedgekeurde regels; de bron van elk record wordt bijgehouden
  3. 3 · Finetuning op een GPULoRA; geen training vanaf nul
  4. 4 · Het examenonze eigen testset; verslaat het het basismodel niet, dan gaat het niet live
  5. 5 · Bij u geïnstalleerduw eigen server of een gehuurde GPU die alleen voor u is; voor persoonsgegevens raden we uw eigen server aan

Onze beloften

Vier beloften

  • Uw data onder uw controle

    Het model wordt getraind en draait op uw eigen server of op een gehuurde GPU die alleen voor u is. Voor modellen die persoonsgegevens gaan verwerken, raden we uw eigen server aan. Verzoeken naar het cloudmodel van een ander AI-bedrijf gaan alleen uit voor taken die u kiest, en alleen als u dat wilt.

  • Model met heldere licentie, herleidbare data

    Het basismodel heeft altijd een licentie voor commercieel gebruik (Apache 2.0 / MIT). Elk trainingsrecord behoudt zijn bron en licentienotitie en kan met één commando uit de training worden verwijderd.

  • Niets uit het hoofd

    Informatie die verandert, zoals prijzen, artikelnummers en beleid, leert het model nooit uit het hoofd; die wordt bij elke vraag uit het document gelezen. Verandert de informatie, dan hoeft het model niet opnieuw getraind te worden.

  • Niets live zonder meting

    Elke versie wordt op onze eigen testset vergeleken met het basismodel; een versie die het niet verslaat, wordt niet gebruikt. Ons doel voor de eerste versie van BALASAGUN: in totaal minstens 10 punten beter, en op geen enkel onderdeel meer dan 2 punten slechter.

Waar we nu staan

Eerlijke stand van zaken

De eerste versie is nog niet getraind; we werken dit onderdeel bij naarmate we vorderen.

  1. 0nu

    Testset en wedstrijd tussen basismodellen

  2. 1

    Datapijplijn

  3. 2

    Training van de eerste versie (v0.1)

  4. 3

    Uitrol en koppeling

  5. v1

    Bredere versie

Trainingsinfrastructuur

Het trainingsmodel van BALASAGUN

Wat we tot nu toe hebben gedaan, met de echte logs: de wedstrijd tussen basismodellen en de eerste proeftraining met LoRA. De volledige training is de volgende stap; hier laten we precies zien wat er is gebeurd.

Wedstrijd tussen basismodellen

Vijf opensourcemodellen namen het tegen elkaar op met 50 vragen uit onze eigen testset (25 elektrotechniek, 25 hotel); een jurymodel met open gewichten beoordeelde de antwoorden. Het gekozen basismodel is Qwen3.6-35B-A3B: eerste in elektrotechniek, Apache-2.0-licentie en geschikt om beide domeinadapters samen op één GPU te serveren.

ModelTotaalElektrotechniekHotel
google/gemma-4-26B-A4B-it87,276,098,4
Qwen/Qwen3.6-35B-A3Bgekozen84,686,482,8
google/gemma-4-12B-it79,664,095,2
Qwen/Qwen3.5-9B73,872,475,2
mistralai/Mistral-Small-3.2-24B-Instruct-250664,655,274,0

Scores op 100 · jury: Qwen3.8-27B · 19 oktober 2026
Eerste proeftraining met LoRA

Vóór de volledige training hebben we de opzet van begin tot eind getest: op hetzelfde basismodel zijn twee LoRA-adapters (elektrotechniek, hotel) elk 20 stappen getraind. De training werkte; de stap daarna, het serveren met vLLM, is in deze proef gecrasht en wordt nu verholpen.

GPU
NVIDIA A100 SXM 80 GB (gehuurd, RunPod)
VRAM-gebruik
69,3 GB (piek 69,6 GB)
Model laden
228 s
Training
2 adapters × 20 stappen, 42 s
Getrainde parameters
3.440.640 per adapter (LoRA r=16)
Loss
elektrotechniek 3,89 → 0,88 · hotel 2,13 → 0,31
Looptijd pod
17 min; verwijderd zodra de taak klaar was
Uit het podlogboek (ongewijzigd)
15:18:59Z {"olay": "yuklendi", "sn": 228.0, "vram_gb": 69.3, "sinif": "Qwen3_5MoeForCausalLM"}
15:19:00Z {"olay": "adaptor", "adaptor": "elektrik", "egitilebilir": 3440640}
15:19:03Z {"olay": "adim", "adaptor": "elektrik", "adim": 0, "loss": 3.892}
15:19:22Z {"olay": "adim", "adaptor": "elektrik", "adim": 19, "loss": 0.8816}
15:19:22Z {"olay": "adaptor", "adaptor": "otel", "egitilebilir": 3440640}
15:19:23Z {"olay": "adim", "adaptor": "otel", "adim": 0, "loss": 2.1289}
15:19:41Z {"olay": "adim", "adaptor": "otel", "adim": 19, "loss": 0.306}
15:19:42Z {"olay": "egitim_bitti", "sn": 270.4, "vram_gb_max": 69.6}
15:20:00Z vLLM version 0.31.0 · model Qwen/Qwen3.6-35B-A3B · lora_modules: elektrik, otel
Durum: BAŞARISIZ — vLLM kapandı (vllm-exited) · GPU: NVIDIA A100-SXM4-80GB · süre: 17 dk

Tijden in UTC. De regels komen uit het eigen logboek van ons trainingsscript.

Uit de RunPod-console

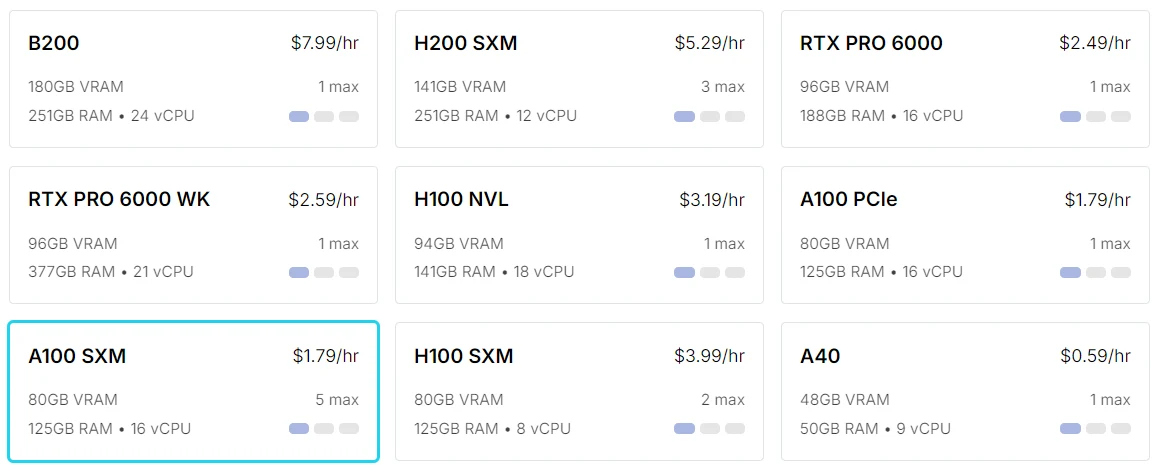
GPU-kaarten in de RunPod-console; de kaart A100 SXM met 80 GB VRAM is gemarkeerd.
GPU-keuze: de proeftraining draaide op een A100 SXM 80 GB (gemarkeerd). Prijzen en beschikbaarheid zijn een momentopname.
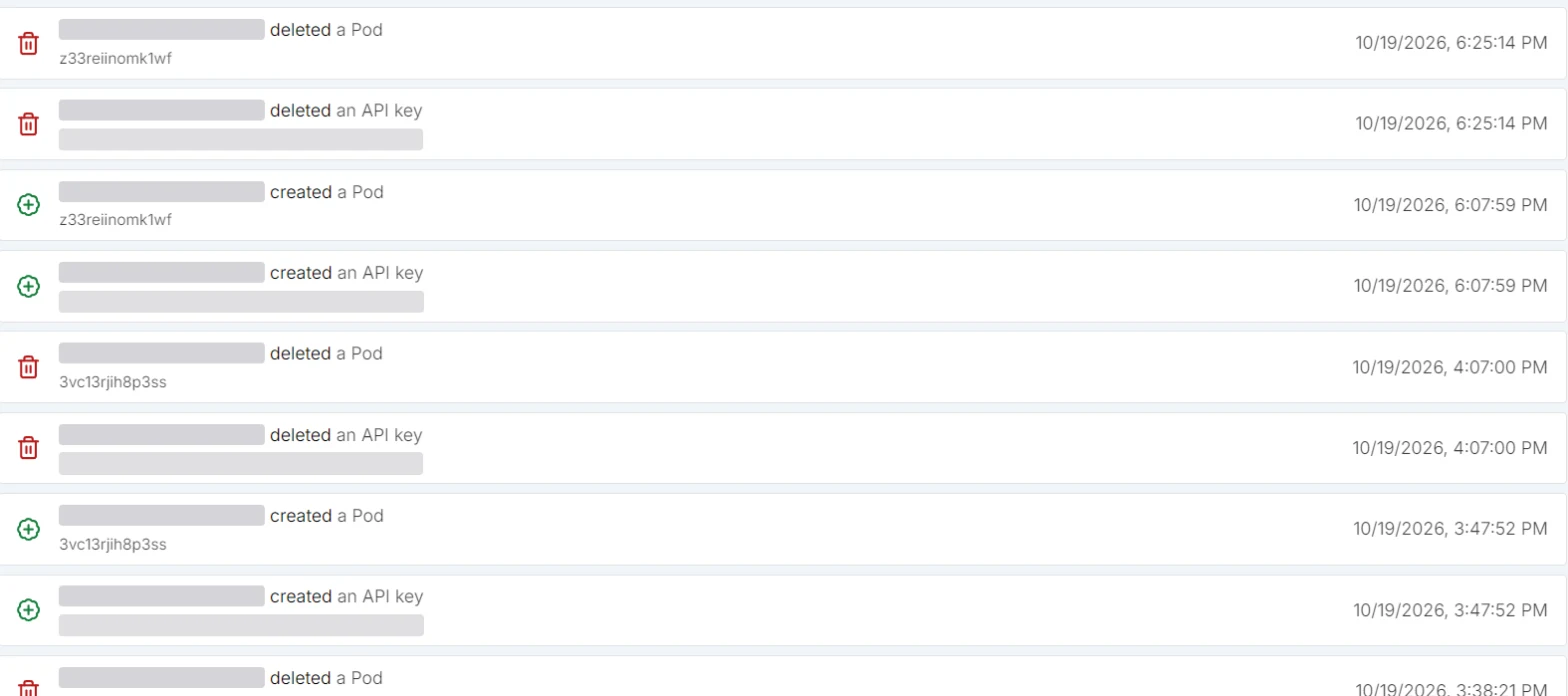
RunPod-auditlog met regels voor het aanmaken en verwijderen van de pod; e-mailadres en sleutel-ID's zijn afgedekt.
Auditlog: de proefpod werd om 18:07 aangemaakt en om 18:25 verwijderd (Turkse tijd). Accountgegevens zijn afgedekt.

Software die we gebruiken

  • Qwen3.6-35B-A3B

    basismodel (Apache-2.0)

  • PyTorch + Hugging Face Transformers

    het model laden en trainen

  • PEFT (LoRA)

    domeinadapters (elektrotechniek, hotel)

  • vLLM 0.31.0

    evaluatie en serveren (OpenAI-compatibel endpoint)

  • RunPod GPU-pods

    gehuurde servers met A100 80 GB en RTX A6000 48 GB

  • Hugging Face Hub

    privérepository's voor modellen en adapters

  • Python 3.12 + uv

    datapijplijn, testset en scoringsscripts

  • Kostenbewaker + Oracle-opruimer

    een pod gaat uit zodra de taak klaar is; een vergeten pod wordt na 1,5 uur verwijderd

Volgende stap: de volledige training

bf16-LoRA-training op door experts goedgekeurde data, op een GPU van 80–96 GB (A100 80 GB of RTX PRO 6000 96 GB). Elke adapter wordt gemeten op de testset van zijn eigen domein; een versie die het basismodel niet verslaat, gaat niet live.

Voor uw sector

We bouwen er ook een voor uw sector.

Zoals we BALASAGUN voor onszelf hebben gebouwd, richten we ook voor uw sector uw eigen taalmodel in en trainen het: op uw eigen server of op gehuurde GPU's.

  • Zorg

    Patiëntvoorlichting, zoeken in protocollen en geneesmiddelenrichtlijnen. Patiëntgegevens blijven op de server van het ziekenhuis.

  • Juridisch

    Dossierarchief en zoeken in jurisprudentie, concepten van processtukken. Cliëntdossiers blijven op kantoor.

  • Financiën en boekhouding

    Facturen lezen, vragen over regelgeving, rekeningoverzichten. Financiële gegevens blijven op de server van het bedrijf.

  • Productie en fabriek

    Machinehandleidingen, onderhoudslogs, storingsdiagnose. Productiedata blijven in de fabriek.

  • Energie en infrastructuur

    Veldrapporten, storingslogs, installatiedocumenten. Net- en installatiedata blijven bij u.

  • Overheid en gemeenten

    Antwoorden op vragen van burgers, zoeken in regelgeving. Persoonsgegevens blijven op de server van de instelling.

  • Onderwijs

    Lesinhoud en een interne kennisassistent. Leerlinggegevens blijven op school.

  • Retail en e-commerce

    Productcatalogus, klantenservice, retourregels. Klantgegevens blijven bij u.

Staat uw sector er niet bij? Schrijf ons; laten we eerst over uw bedrijf en uw data praten.Offerte aanvragen

Samenwerken

Van het eerste gesprek tot een werkend model

Doorlooptijd en prijs hangen af van uw bedrijf en uw data; na het verkennend gesprek sturen we u een schriftelijke offerte.

  1. 1. Verkennend gesprek

    We bespreken uw bedrijf, uw data en uw eisen op het gebied van privacy.

  2. 2. Data-inventaris en testset

    We brengen in kaart welke documenten en records worden gebruikt en stellen een testset samen uit uw echte vragen.

  3. 3. Pilotmodel

    We laten kandidaat-basismodellen tegen elkaar strijden, passen de winnaar aan met finetuning en geven u het meetrapport.

  4. 4. Installatie

    We installeren het model op uw eigen server of op een gehuurde GPU die alleen voor u is en koppelen het aan uw systemen.

  5. 5. Onderhoud en nieuwe versies

    We werken het model bij met nieuwe documenten en vragen en meten elke versie opnieuw.

Inrichting van server en datacenter (F09)

Offerte

Vertel ons over uw sector en uw data; we stellen een offerte op voor uw eigen model.

Beschrijf kort wat u doet en welke data u hebt; we nemen contact met u op om een verkennend gesprek in te plannen.

Kies de lijn waarin u geïnteresseerd bent

De huidige situatie en het gewenste resultaat zijn genoeg.

Uw bericht gaat rechtstreeks naar ons team. Om het naar de juiste lijn te sturen, wordt de berichttekst vooraf door AI gesorteerd; uw naam en contactgegevens gaan niet naar die stap.