본문으로 건너뛰기

BALASAGUN · BRAINSTORM의 자체 언어 모델

발라사군: 쿠타드구 빌리그의 도시

발라사군은 카라한 왕조의 수도 가운데 하나로, 오늘날 키르기스스탄 땅의 추강 유역에 있었습니다. 쿠타드구 빌리그의 저자 유수프 하스 하지브는 이 도시에서 태어나 이곳에서 작품을 쓰기 시작했고, 1069–70년 카슈가르에서 완성했습니다.

쿠타드구 빌리그는 “행복해지는 지식”이라는 뜻입니다. 우리 모델의 이름은 이 도시에서 따왔습니다.

귀사만의 언어 모델을 만드세요.

귀사를 위해 만들어, 귀사의 자체 서버나 임대 GPU에 상주하며 일하는 AI 언어 모델입니다. 모델은 귀사 업무의 언어로 말하며, 귀사가 따로 정하지 않는 한 질문과 문서는 다른 AI 회사로 가지 않습니다.

현황

개발 중 · 단계 0 / 3 · 2026년 10월

작동 방식

모델은 귀사의 서버에 상주합니다

귀사의 서버 · 또는 임대 GPU011011001001101101외부 AI 서비스✕귀사의 시스템PMS · ERP · SCADA귀사의 문서규정 · 정책BALASAGUN귀사의 서버에서BALASAGUN도구계산 · 작업 지시서사용자304호 객실 에어컨이작동하지 않습니다.304호 · 유지보수 기록작업 지시서 발행: 에어컨, 304호시설팀에 작업 지시서를 발행했고,담당 팀이 객실로 향하고 있습니다.세대의 설비 용량은 12 kW입니다.수요 전력은 얼마입니까?튀르키예 전기설비규정제57조 · 수용률8 kW × 0.6 + 4 kW × 0.4수요 전력은 6.4 kW입니다.출처: 전기설비규정 제57조

애니메이션: 목표로 하는 작동 방식입니다. 모델은 아직 개발 중입니다.

호텔

  1. 투숙객이 프런트에 “304호 객실 에어컨이 작동하지 않습니다”라고 보냅니다.
  2. BALASAGUN은 호텔의 자체 서버에서 실행되며, 질문은 다른 회사로 가지 않습니다.
  3. 객실의 유지보수 기록과 호텔 시스템을 확인합니다.
  4. 시설팀에 작업 지시서를 발행합니다.
  5. 답변은 투숙객에게 돌아가고, 작업 지시서는 시설팀에 전달됩니다.

전기

  1. 엔지니어가 묻습니다. “세대의 설비 용량은 12 kW입니다. 수요 전력은 얼마입니까?”
  2. 모델은 귀사의 서버에서 생각합니다.
  3. 규정의 수용률 규칙을 암기가 아니라 문서에서 직접 읽습니다.
  4. 도구로 계산합니다. 처음 8 kW에는 0.6, 나머지에는 0.4를 적용합니다.
  5. 답변이 출처와 함께 돌아옵니다. 수요 전력은 6.4 kW입니다.
  1. 1 · 질문이 들어옵니다투숙객, 직원 또는 엔지니어가 묻습니다
  2. 2 · 모델이 생각합니다귀사의 서버에서, 다른 회사를 거치지 않고
  3. 3 · 출처를 확인합니다규정, 유지보수 기록, 호텔 정책
  4. 4 · 작업을 실행합니다계산하고, 작업 지시서를 발행합니다
  5. 5 · 답변이 돌아옵니다출처와 함께

BALASAGUN이란?

전기 엔지니어링과 호텔을 위한 우리의 자체 언어 모델

BALASAGUN은 우리가 지금 전기 엔지니어링과 호텔 경영 분야로 학습시키고 있는 자체 AI 언어 모델입니다. 처음부터 학습시키지 않습니다. 오픈 소스 언어 모델을 우리의 엔지니어링 노하우로 필요한 업종에 맞게 학습시킨 뒤 서비스에 투입해 운영합니다. 덕분에 값비싼 언어 모델을 쓰는 대신 우리 자체 언어 모델로 솔루션을 만듭니다. 또한 귀사를 위해 개발하는 귀사만의 LLM을 귀사가 원하는 다른 LLM과 하이브리드로 함께 작동하도록 구성할 수도 있습니다.

  • 호텔 경영

    투숙객 문의, 시설 관리, 에너지와 유지보수 관리, 직원 업무. 호텔 고유의 규칙과 가격은 질문마다 호텔 문서에서 읽습니다.

  • 전기 엔지니어링

    전기설비, 접지, 강전설비에 관한 튀르키예 규정. 전압 강하, 수요 전력, 물량 조사와 수량 산출 계산.

  • 첫 사용자: 우리 자체 제품

    물량 조사 소프트웨어 Elektrik GPT, 이 사이트의 도우미 Leyla, ARI 에너지 모니터링이 BALASAGUN을 가장 먼저 사용할 제품입니다.

    Elektrik GPT에너지 플랫폼

우리의 방식

다섯 단계로 만드는 귀사의 모델

모든 모델은 같은 다섯 단계를 거칩니다. BALASAGUN도 이 방식으로 학습시키고 있으며, 귀사의 모델도 같은 방식으로 구축합니다.

만드는 과정

오픈 모델에서 귀사의 모델로

귀사 전용 환경✓✓✓우리 테스트 세트기반 모델조정된 모델목표: 기반 + 10점 이상오픈 모델Apache 2.0귀사의 지식전문가 검증GPU · 미세 조정LoRA귀사의 자체 서버임대 GPU귀사 전용
  1. 상업적 이용이 가능한 라이선스(Apache 2.0)의 기반 모델을 고릅니다. 처음부터 학습하지 않습니다.
  2. 법규, 귀사의 문서, 전문가가 검증한 규칙을 더하고, 모든 기록의 출처를 추적합니다.
  3. GPU에서 LoRA로 미세 조정합니다. 모델이 귀사 업무의 언어를 배웁니다.
  4. 우리 테스트 세트로 시험합니다. 기반 모델을 넘지 못하면 운영에 투입하지 않습니다.
  5. 귀사의 자체 서버나 귀사 전용 임대 GPU에 설치합니다.
  1. 1 · 오픈 모델을 고릅니다Apache 2.0으로 상업적 이용이 가능하며, 라이선스는 모델 카드에서 확인합니다
  2. 2 · 귀사의 지식을 더합니다법규, 귀사의 문서, 전문가가 검증한 규칙을 넣고, 모든 기록의 출처를 추적합니다
  3. 3 · GPU에서 미세 조정합니다LoRA를 쓰며, 처음부터 학습하지 않습니다
  4. 4 · 시험을 거칩니다우리 테스트 세트로 평가하며, 기반 모델을 넘지 못하면 운영에 투입하지 않습니다
  5. 5 · 귀사에 설치합니다귀사의 자체 서버나 귀사 전용 임대 GPU에 설치하며, 개인정보를 처리한다면 자체 서버를 권장합니다

우리의 약속

네 가지 약속

  • 데이터는 귀사의 통제 아래

    모델은 귀사의 자체 서버나 귀사 전용 임대 GPU에서 학습하고 실행됩니다. 개인정보를 처리할 모델에는 자체 서버를 권장합니다. 다른 AI 회사의 클라우드 모델로 요청을 보내는 일은 귀사가 선택한 작업에 한해, 원하실 때만 이루어집니다.

  • 라이선스가 명확한 모델, 출처를 추적하는 데이터

    기반 모델은 항상 상업적 이용이 가능한 라이선스(Apache 2.0 / MIT)입니다. 모든 학습 기록에는 출처와 라이선스 메모가 남으며, 명령 하나로 학습에서 제외할 수 있습니다.

  • 암기하지 않습니다

    가격, 조항 번호, 정책처럼 바뀌는 정보는 모델에 암기시키지 않고, 질문할 때마다 문서에서 읽습니다. 정보가 바뀌어도 모델을 다시 학습시킬 필요가 없습니다.

  • 측정 없이는 출시하지 않습니다

    모든 버전은 우리 테스트 세트에서 기반 모델과 비교하며, 기반 모델을 넘지 못한 버전은 사용하지 않습니다. BALASAGUN 첫 버전의 목표는 전체 점수 10점 이상 향상, 그리고 어떤 영역에서도 2점 넘게 하락하지 않는 것입니다.

현재 위치

솔직한 현황

첫 버전은 아직 학습되지 않았습니다. 진행에 따라 이 섹션을 업데이트합니다.

  1. 0현재

    테스트 세트와 기반 모델 비교 평가

  2. 1

    데이터 파이프라인

  3. 2

    첫 버전 학습(v0.1)

  4. 3

    서비스 제공과 연동

  5. v1

    확장 버전

학습 인프라

BALASAGUN 학습 모델

지금까지 한 일을 실제 기록과 함께 보여 드립니다. 기반 모델 비교 평가와 첫 LoRA 시험 학습입니다. 본 학습은 다음 단계이며, 여기서는 실제로 일어난 일을 그대로 보여 드립니다.

기반 모델 비교 평가

다섯 개의 오픈 소스 모델이 우리 테스트 세트의 50문항(전기 25, 호텔 25)으로 겨루었고, 오픈 웨이트 심사 모델이 답변을 채점했습니다. 선정된 기반 모델은 Qwen3.6-35B-A3B입니다. 전기 분야 1위이고, 라이선스는 Apache-2.0이며, 두 분야 어댑터를 GPU 한 대에서 함께 서비스하기에 적합합니다.

모델합계전기호텔
google/gemma-4-26B-A4B-it87.276.098.4
Qwen/Qwen3.6-35B-A3B선정84.686.482.8
google/gemma-4-12B-it79.664.095.2
Qwen/Qwen3.5-9B73.872.475.2
mistralai/Mistral-Small-3.2-24B-Instruct-250664.655.274.0

100점 만점 · 심사: Qwen3.8-27B · 2026년 10월 19일
첫 LoRA 시험 학습

본 학습에 앞서 전체 구성을 처음부터 끝까지 시험했습니다. 같은 기반 모델 위에서 LoRA 어댑터 두 개(전기, 호텔)를 각각 20스텝씩 학습시켰습니다. 학습은 정상적으로 진행되었지만, 이어지는 vLLM 서비스 단계는 이번 시험에서 비정상 종료되었으며 현재 수정 중입니다.

GPU
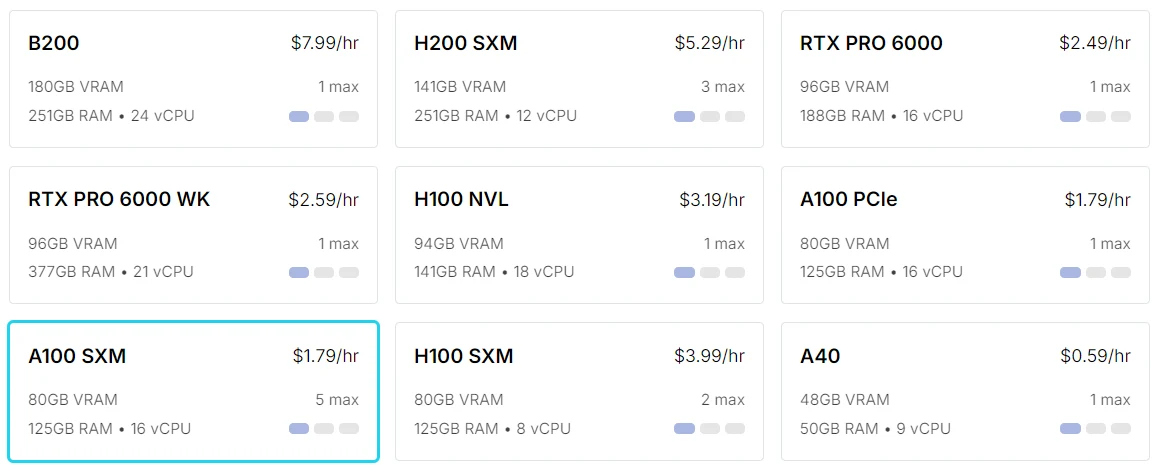
NVIDIA A100 SXM 80 GB(임대, RunPod)
VRAM 사용량
69.3 GB(최대 69.6 GB)
모델 로딩
228초
학습
어댑터 2개 × 20스텝, 42초
학습된 파라미터
어댑터당 3,440,640개(LoRA r=16)
손실(Loss)
전기 3.89 → 0.88 · 호텔 2.13 → 0.31
Pod 사용 시간
17분, 작업이 끝난 뒤 삭제
Pod 로그에서(원문 그대로)
15:18:59Z {"olay": "yuklendi", "sn": 228.0, "vram_gb": 69.3, "sinif": "Qwen3_5MoeForCausalLM"}
15:19:00Z {"olay": "adaptor", "adaptor": "elektrik", "egitilebilir": 3440640}
15:19:03Z {"olay": "adim", "adaptor": "elektrik", "adim": 0, "loss": 3.892}
15:19:22Z {"olay": "adim", "adaptor": "elektrik", "adim": 19, "loss": 0.8816}
15:19:22Z {"olay": "adaptor", "adaptor": "otel", "egitilebilir": 3440640}
15:19:23Z {"olay": "adim", "adaptor": "otel", "adim": 0, "loss": 2.1289}
15:19:41Z {"olay": "adim", "adaptor": "otel", "adim": 19, "loss": 0.306}
15:19:42Z {"olay": "egitim_bitti", "sn": 270.4, "vram_gb_max": 69.6}
15:20:00Z vLLM version 0.31.0 · model Qwen/Qwen3.6-35B-A3B · lora_modules: elektrik, otel
Durum: BAŞARISIZ — vLLM kapandı (vllm-exited) · GPU: NVIDIA A100-SXM4-80GB · süre: 17 dk

시각은 UTC 기준입니다. 각 줄은 우리 학습 스크립트가 직접 남긴 로그입니다.

RunPod 콘솔에서

RunPod 콘솔의 GPU 카드. A100 SXM 80 GB VRAM 카드가 강조 표시되어 있습니다.
GPU 선택: 시험 학습은 A100 SXM 80 GB에서 실행했습니다(강조 표시). 가격과 재고는 실시간 값입니다.
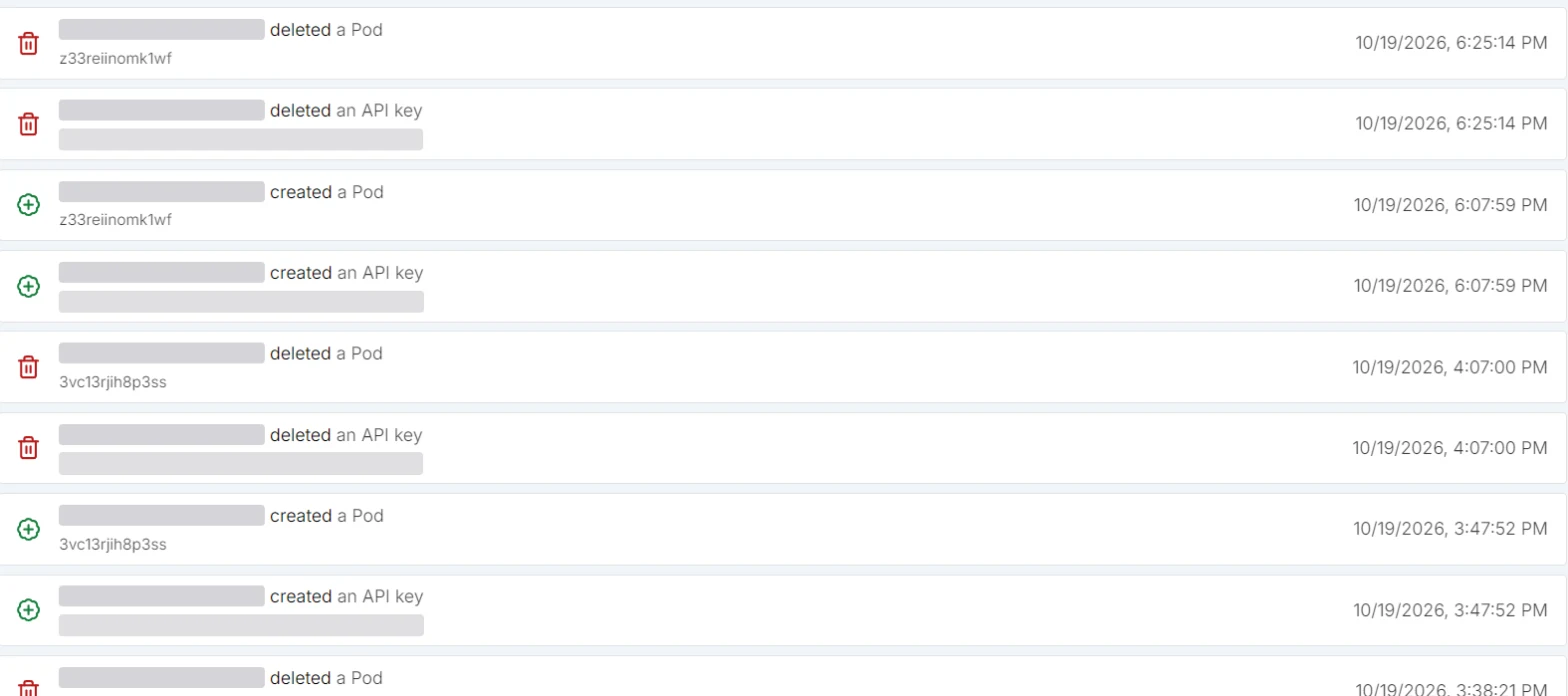
pod 생성 및 삭제 행이 있는 RunPod 감사 로그. 이메일과 키 ID는 가려져 있습니다.
감사 로그: 시험용 pod는 18:07에 생성되어 18:25에 삭제되었습니다(튀르키예 시간). 계정 정보는 가렸습니다.

사용하는 소프트웨어

  • Qwen3.6-35B-A3B

    기반 모델(Apache-2.0)

  • PyTorch + Hugging Face Transformers

    모델 로딩과 학습

  • PEFT (LoRA)

    분야별 어댑터(전기, 호텔)

  • vLLM 0.31.0

    평가와 서비스(OpenAI 호환 엔드포인트)

  • RunPod GPU 파드

    임대 A100 80 GB 및 RTX A6000 48 GB 서버

  • Hugging Face Hub

    모델과 어댑터를 위한 비공개 저장소

  • Python 3.12 + uv

    데이터 파이프라인, 테스트 세트, 채점기

  • 비용 감시기 + Oracle 정리기

    작업이 끝나면 pod가 꺼지고, 잊힌 pod는 1.5시간 뒤 삭제됩니다

다음 단계: 본 학습

전문가가 검증한 데이터로 80–96 GB GPU(A100 80 GB 또는 RTX PRO 6000 96 GB)에서 bf16 LoRA 학습을 진행합니다. 각 어댑터는 해당 분야의 테스트 세트로 측정하며, 기반 모델을 넘지 못한 버전은 운영에 투입하지 않습니다.

귀사의 업종을 위해

귀사의 업종에도 만들어 드릴 수 있습니다.

우리가 BALASAGUN을 직접 만든 것처럼, 귀사의 업종을 위한 자체 언어 모델도 구축하고 학습시킵니다. 귀사의 자체 서버에서도, 임대 GPU에서도 가능합니다.

  • 의료

    환자 안내, 진료 지침과 의약품 가이드 검색. 환자 데이터는 병원 서버에 남습니다.

  • 법률

    사건 기록 보관소와 판례 검색, 서면 초안. 의뢰인 파일은 사무소 안에 남습니다.

  • 금융과 회계

    청구서 판독, 법규 질의, 거래처 원장 요약. 재무 기록은 회사 서버에 남습니다.

  • 제조와 공장

    기계 매뉴얼, 유지보수 기록, 고장 진단. 생산 데이터는 공장 안에 남습니다.

  • 에너지와 인프라

    현장 보고서, 고장 기록, 설비 문서. 전력망과 설비 데이터는 귀사에 남습니다.

  • 공공기관과 지자체

    민원 답변, 법규 검색. 개인정보는 기관 서버에 남습니다.

  • 교육

    강의 콘텐츠와 기관 내부 지식 도우미. 학생 데이터는 학교 안에 남습니다.

  • 유통과 이커머스

    상품 카탈로그, 고객 서비스, 반품 규정. 고객 데이터는 귀사에 남습니다.

귀사의 업종이 목록에 없나요? 연락 주세요. 먼저 귀사의 업무와 데이터에 대해 이야기하겠습니다.견적 요청

함께 일하는 방식

첫 상담에서 작동하는 모델까지

기간과 비용은 귀사의 업무와 데이터에 따라 달라집니다. 사전 상담 후 서면 견적을 드립니다.

  1. 1. 사전 상담

    귀사의 업무, 데이터, 개인정보 보호 요구 사항을 함께 논의합니다.

  2. 2. 데이터 목록과 테스트 세트

    어떤 문서와 기록을 사용할지 정리하고, 귀사의 실제 질문으로 테스트 세트를 만듭니다.

  3. 3. 파일럿 모델

    후보 기반 모델을 서로 겨루게 하고, 가장 앞선 모델을 미세 조정으로 맞춘 뒤, 측정 보고서를 드립니다.

  4. 4. 설치

    모델을 귀사의 자체 서버나 귀사 전용 임대 GPU에 설치하고 귀사의 시스템에 연결합니다.

  5. 5. 유지보수와 새 버전

    새 문서와 질문으로 모델을 업데이트하고, 버전마다 다시 측정합니다.

서버와 데이터센터 구축(F09)

견적 요청

귀사의 업종과 데이터를 알려 주세요. 귀사만의 모델 견적을 준비하겠습니다.

업무와 보유한 데이터를 간단히 적어 주세요. 사전 상담 일정을 잡기 위해 연락드리겠습니다.

관심 있는 라인을 선택하세요

현재 상황과 원하는 결과만 적어 주셔도 충분합니다.

메시지는 우리 팀에 바로 전달됩니다. 알맞은 라인으로 보내기 위해 메시지 본문은 AI로 사전 분류되며, 이름과 연락처는 이 단계에 전달되지 않습니다.